七维拆解
把一张参考图反推成可直接出图的 prompt。
核心就一句话:先把图说清楚,再让 AI 扩写 —— 不要一上来就堆关键词。
执行流程
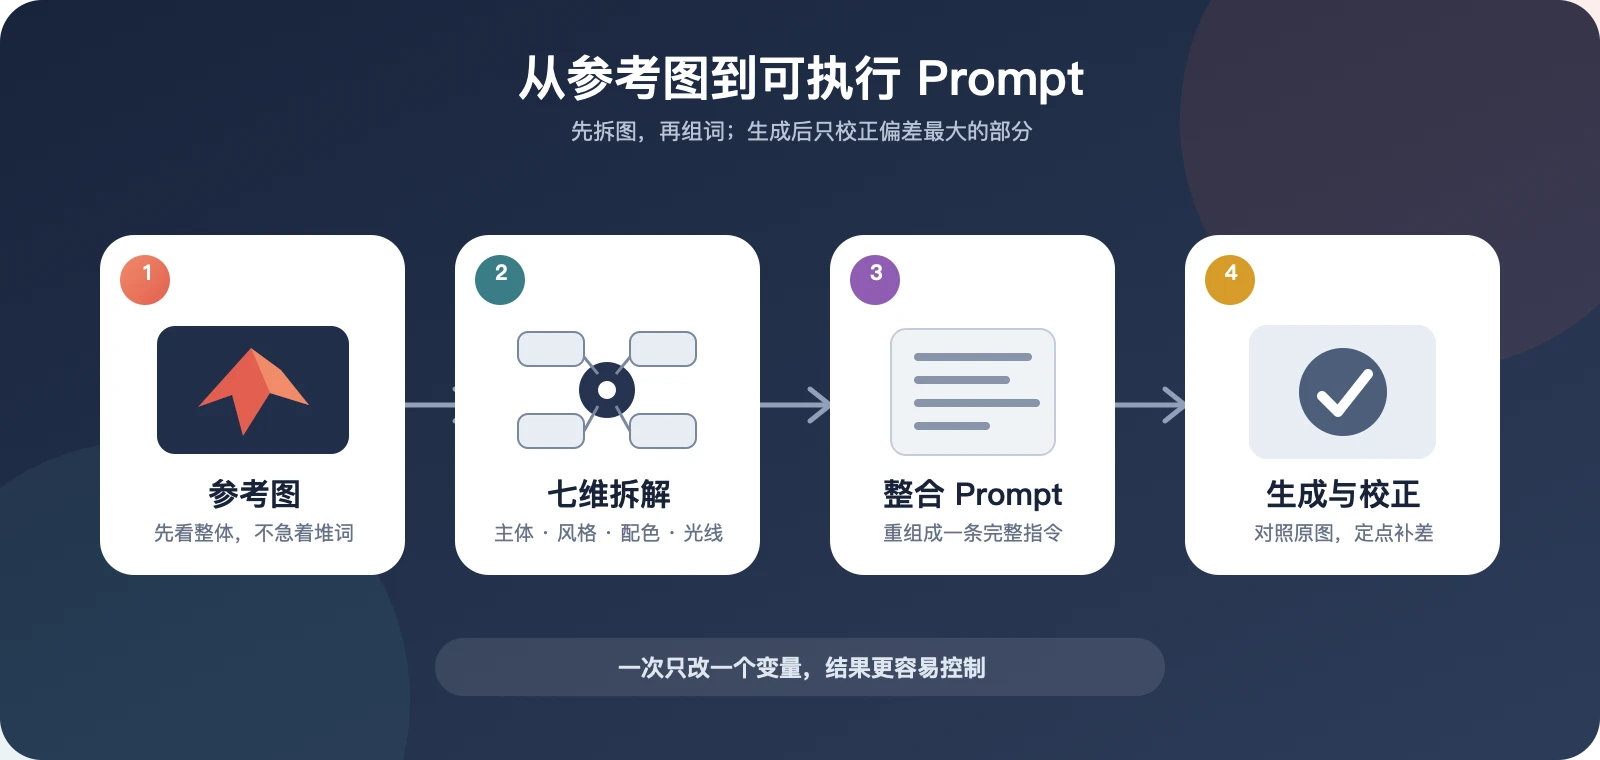
AI 拿到一张参考图时,按下面四步做:
- 看整体:先用一句话说清这张图画的是什么,不急着写关键词
- 七维拆解:按下一节的七个维度逐项写结论;再按图的类型补上该类的专项维度(见按图类换重点)
- 整合 prompt:把七项结论重组成一条连贯的描述,补上清晰度、画幅和镜头,并且不许偏离原图
- 生成与校正:出图后跟原图对比,找出偏差最大的那一维,每轮只改这一维
一次只改一个变量,结果更容易控制。
这句话是整套方法里最值钱的。前三步都在写 prompt,第 4 步其实是在做控制变量实验:同时改三维就分不清是哪一维起了作用,下一轮只能靠猜。
七个维度
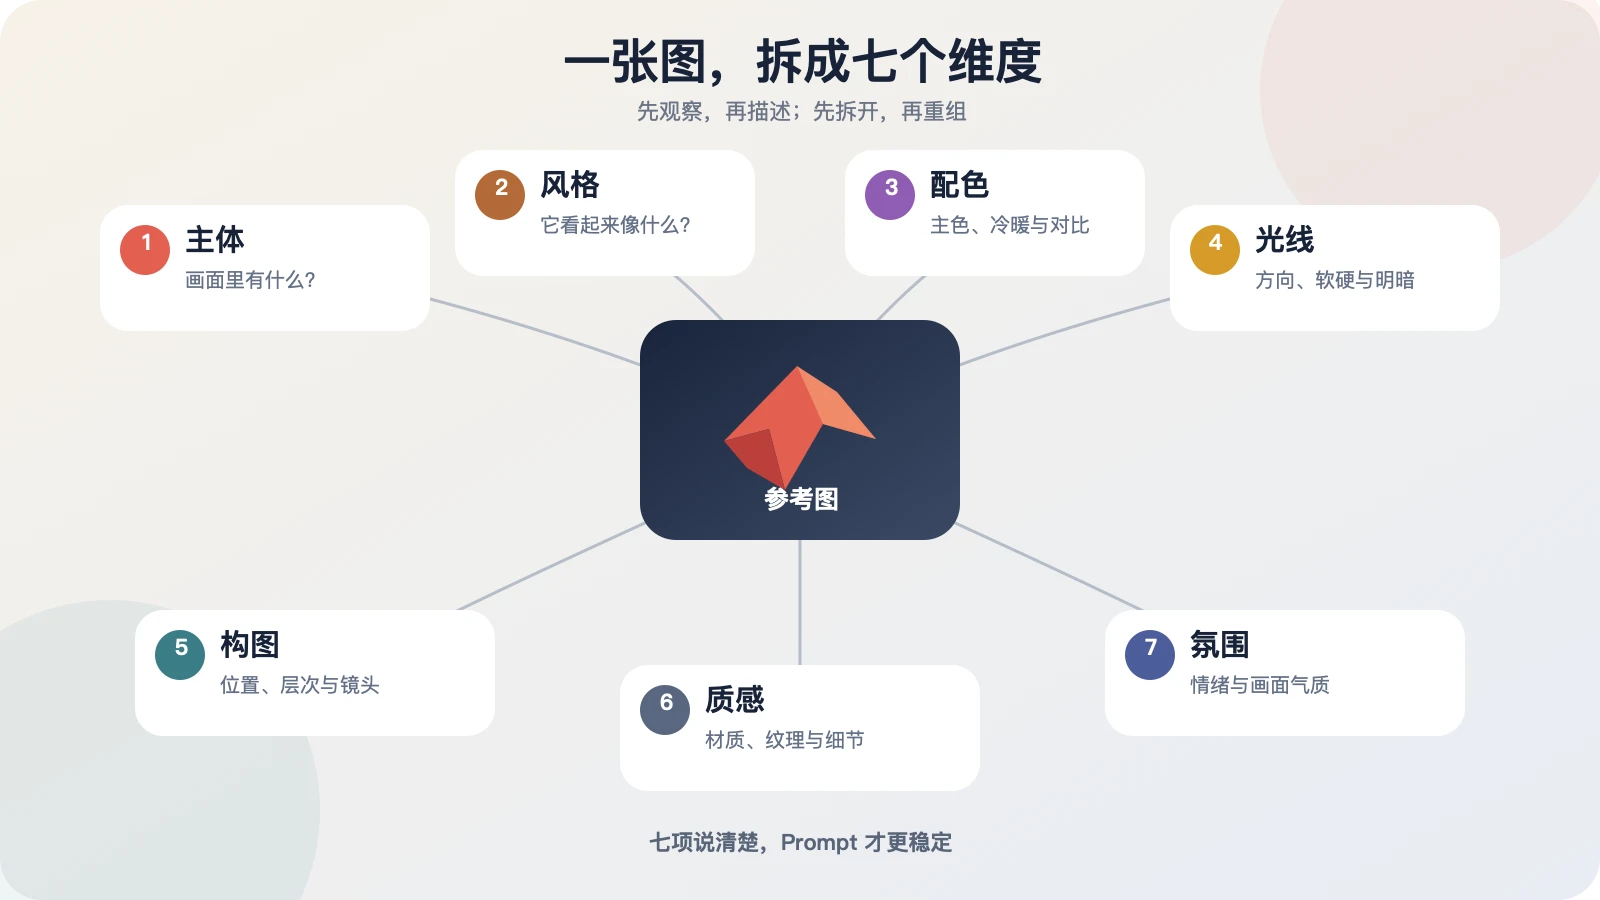
| # | 维度 | 回答什么问题 |
|---|---|---|
| 1 | 主体 | 画面里有什么 |
| 2 | 风格 | 它看起来像什么(画册摄影、3D 渲染、扁平插画……) |
| 3 | 配色 | 主色是什么,冷暖怎么分,对比强不强 |
| 4 | 光线 | 光从哪个方向来,是软光还是硬光,整体明暗如何 |
| 5 | 构图 | 主体在什么位置,前后怎么分层,用什么镜头 |
| 6 | 质感 | 材质、纹理和细节 |
| 7 | 氛围 | 画面传达什么情绪 |
原帖对拆解顺序的说法是:
先看主体,再辨风格;接着判断配色和光线;然后看构图与质感;最后归纳情绪和氛围。
这个顺序是从客观到主观:主体和配色几乎不会看错,氛围最主观,放到最后,前面六项已经给它定好了调。反过来先写「安静、克制、高级感」,这类词就会压过后面的具体描述,模型更容易照着形容词自由发挥。
七维之间也有重叠。「风格」一项里往往已经隐含了光线和质感,比如「画册级静物摄影」本身就暗示了柔和侧光和清楚的材质肌理。所以拆完以后,整合时要把重复的描述删掉,不然同一件事说三遍,权重会被悄悄放大。
按图类换重点
七维是所有图通用的,不同类型的图各有决定成败的那几维。原帖给了五类,我把每类「先看什么」压成一行:
| 图类 | 先锁定 | 容易漏掉 |
|---|---|---|
| 字体 / Logo | 字形结构:有没有衬线、粗细变化、字距 | 背景材质、光效、版式(居中 / 环绕 / 重组) |
| 风景 / 场景 | 前景、中景、远景三层分别有什么 | 时段(黄昏 / 蓝调 / 深夜)、云雾状态、原图的空间关系 |
| 摄影 / 人像 | 焦段、光圈和景深、光源方向 | 肤质、人物情绪、后期色调(胶片 / 清冷 / 暖调) |
| 3D / C4D 渲染 | 材质系统:金属、玻璃、塑料还是黏土 | 灯光方案(三点光 / HDRI / 体积光)、反射和透光、渲染器气质 |
| IP 角色 / 潮玩 | 头身比例和五官设计 | 材质手感(树脂 / 搪胶 / PVC / 毛绒)、姿态、展示视角 |
规律很明显:每类图先锁定的,都是这一类最难靠形容词补回来的硬参数。字形、景深、头身比都是这样,错了之后,后面的描述写得再好也救不回来。
原帖的六张示例图与「看图重点」
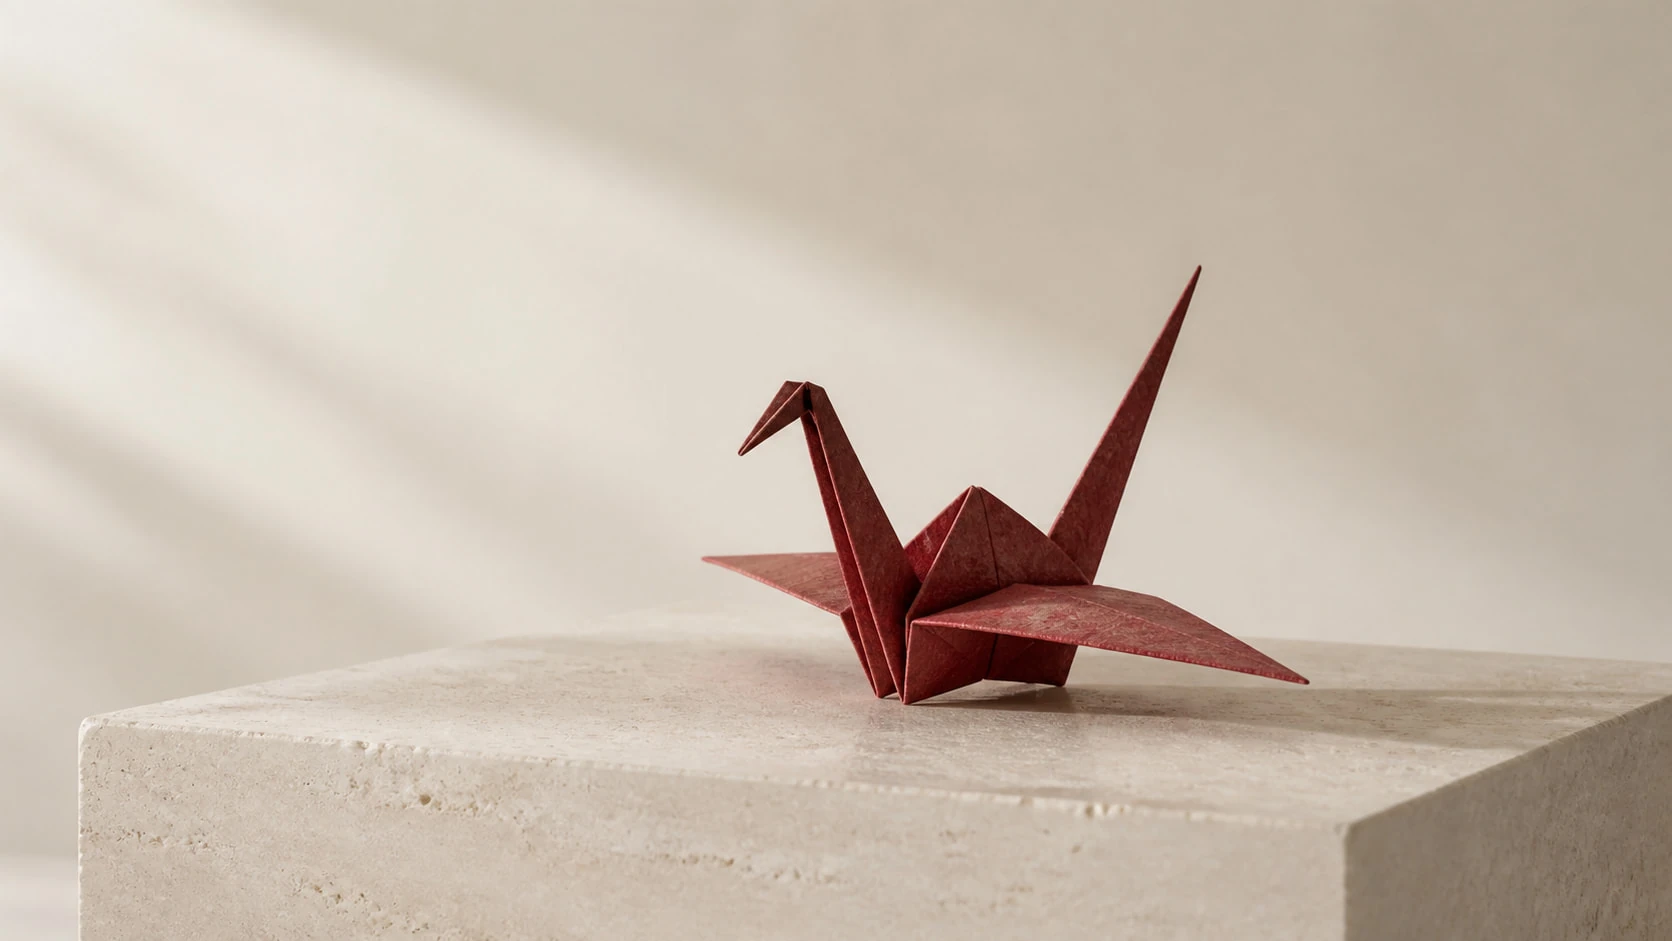
看图重点: 主体是酒红色和纸折鹤;风格偏画册级静物摄影;配色为象牙白、暖灰与低饱和酒红;自然侧光配合轻微非对称构图;和纸纤维与洞石肌理清楚;氛围安静、克制、自信。
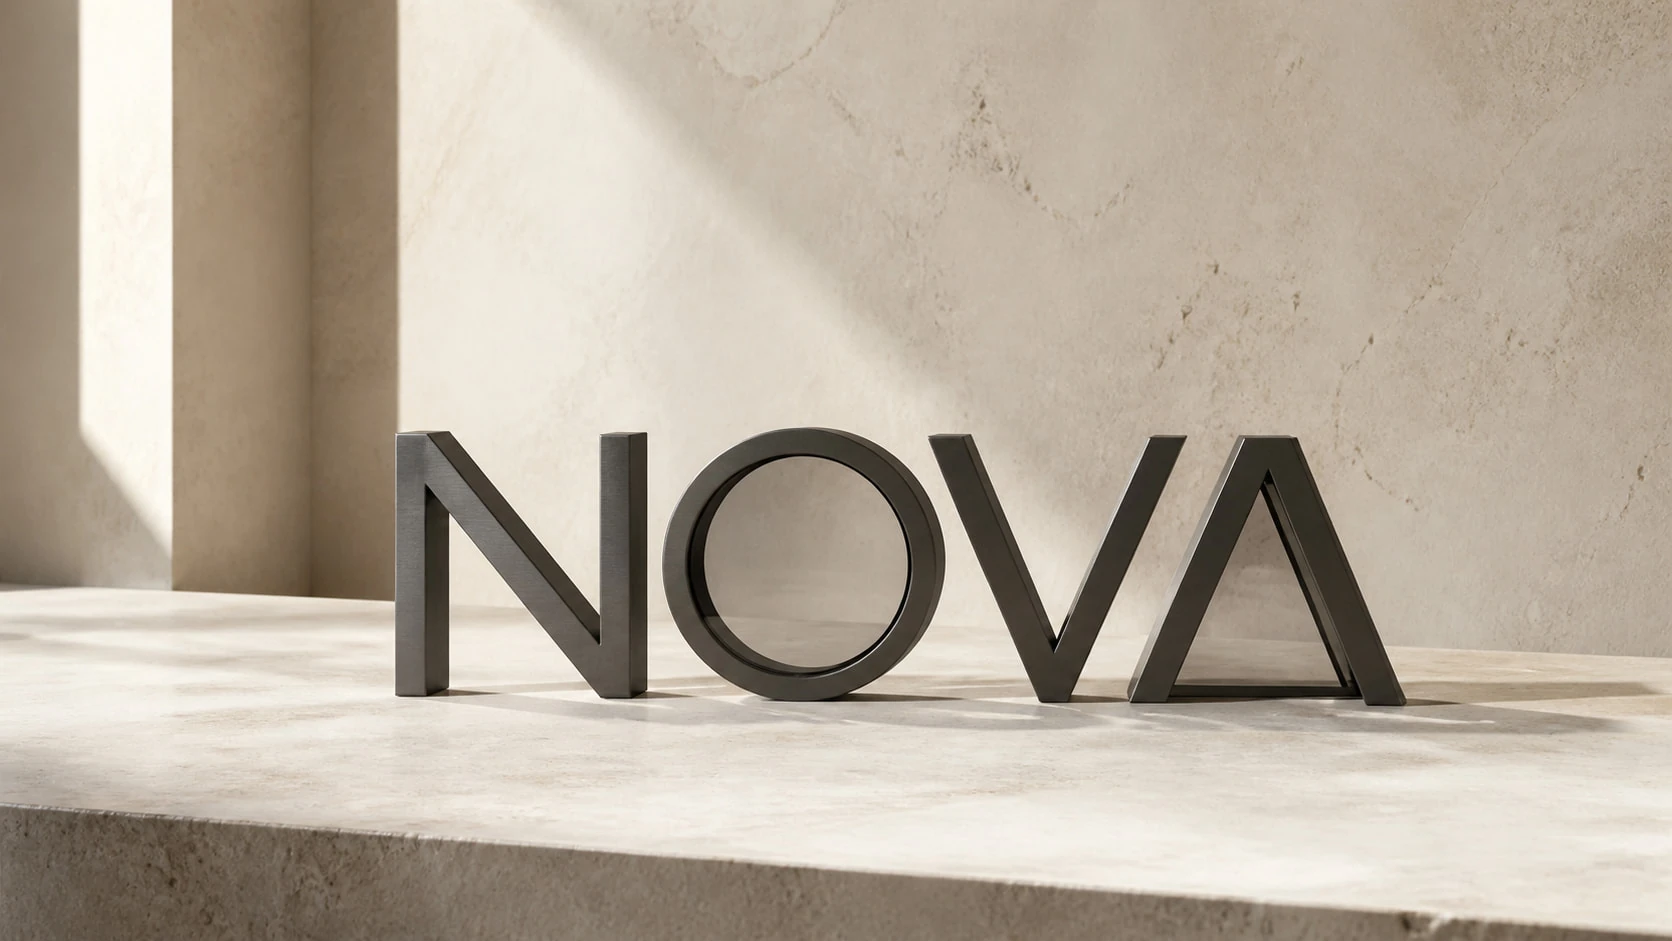
看图重点: 先辨认几何无衬线字形、字距与笔画比例,再观察石墨色拉丝金属、实体字标的空间关系、非对称留白、天然石材背景和柔和侧光。
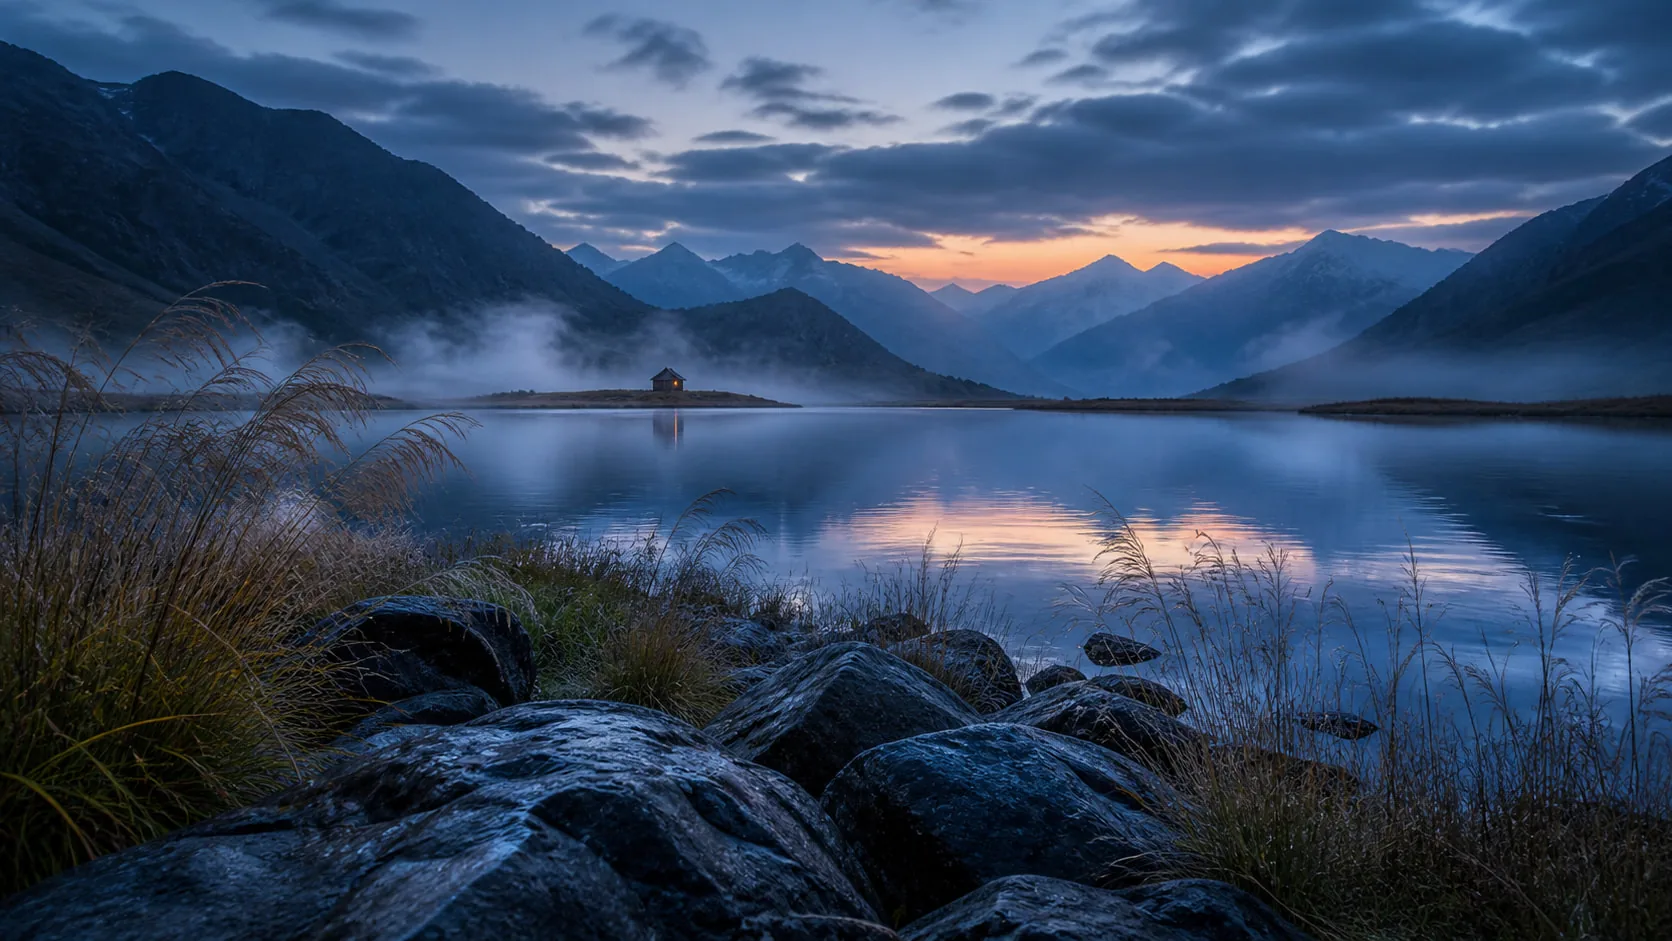
看图重点: 前景看岩石和芒草,中景看湖面与木屋,远景看山峰和云层;再判断蓝调时刻、地平线暖光、薄雾和广角镜头。
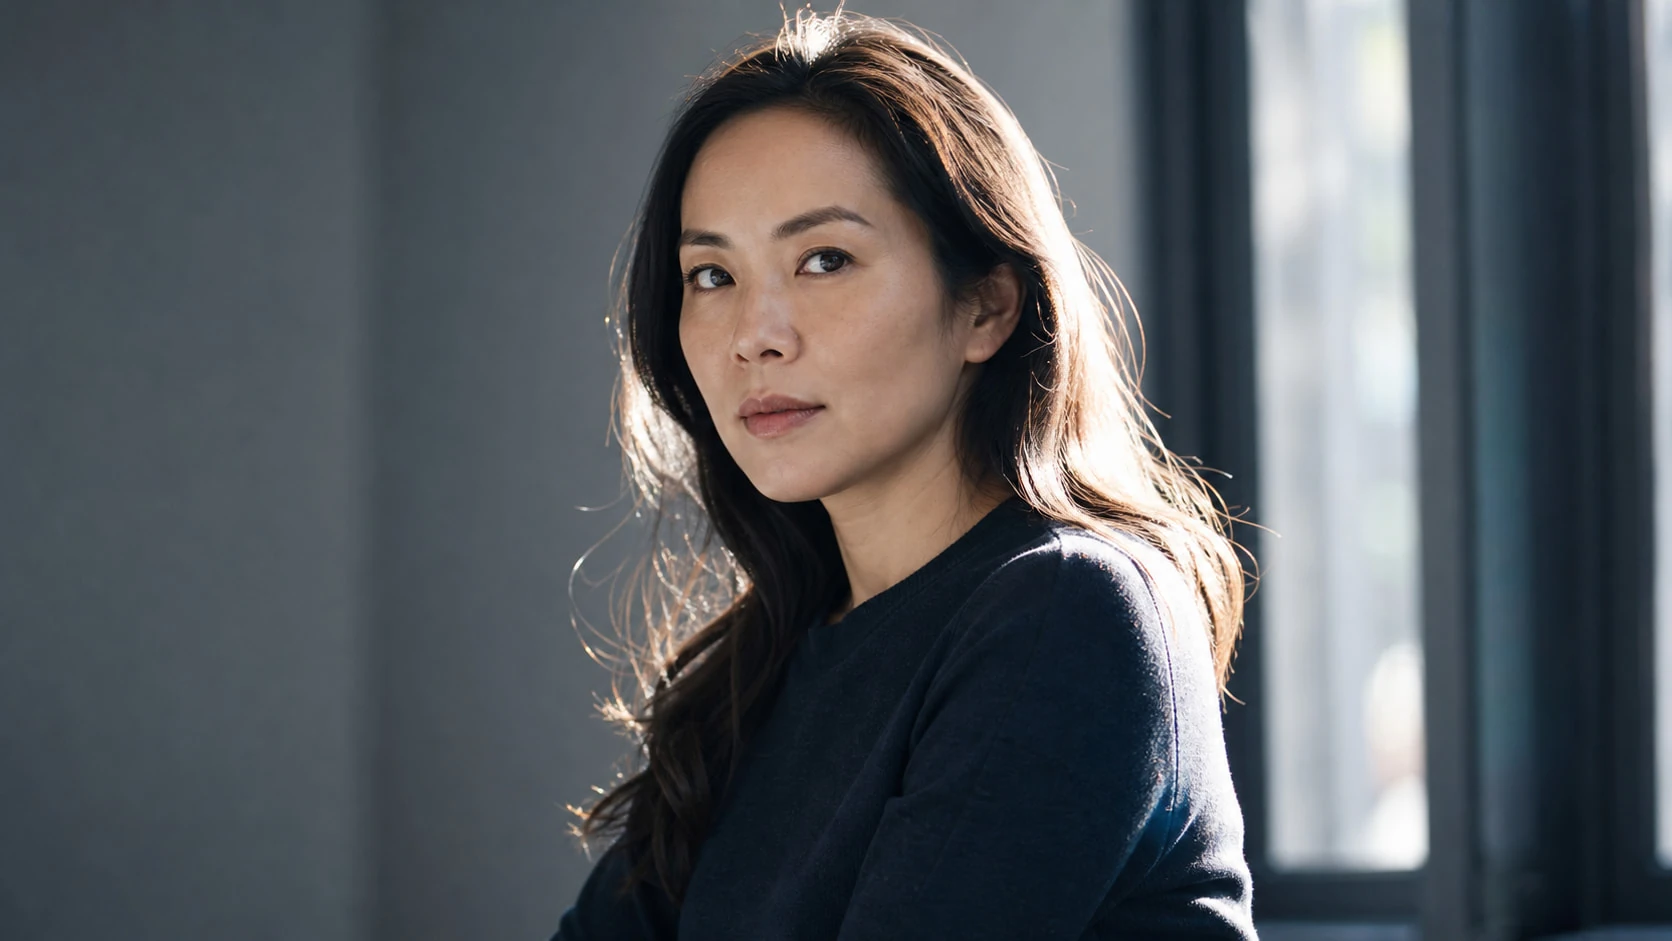
看图重点: 观察 85mm 视角、浅景深、窗边侧逆光、发丝轮廓光、暖肤色与冷灰蓝环境,以及人物安静坚定的情绪。
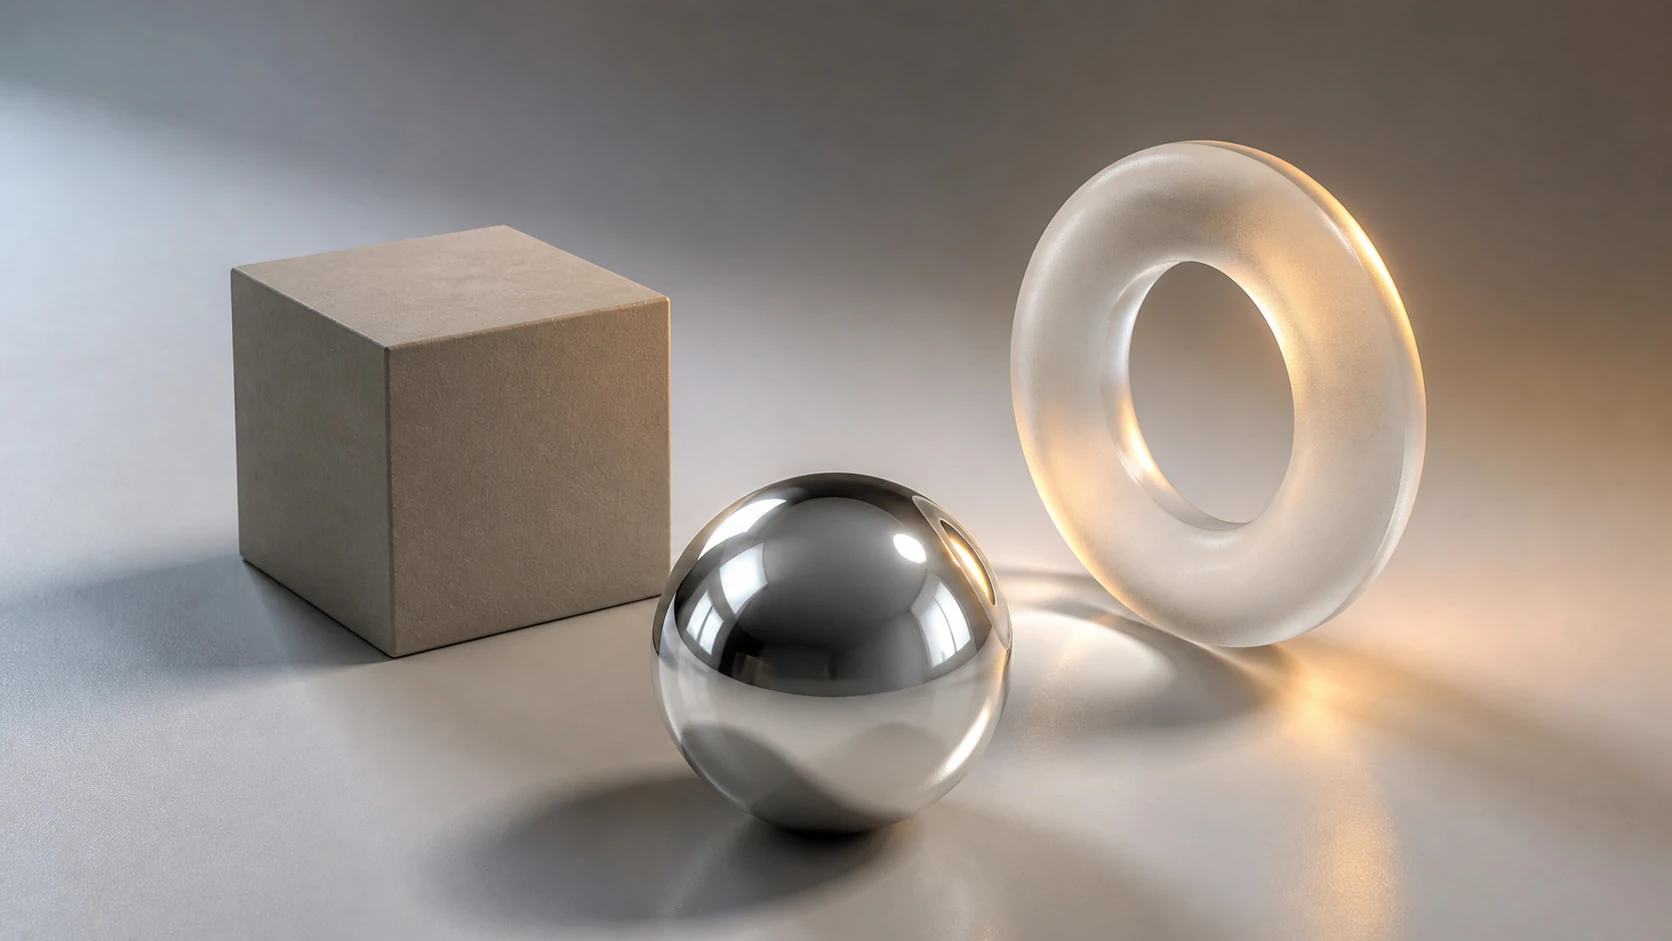
看图重点: 对比哑光黏土、镜面金属和磨砂玻璃,继续判断三点布光、反射/透光、体积光、台面布局与景深。
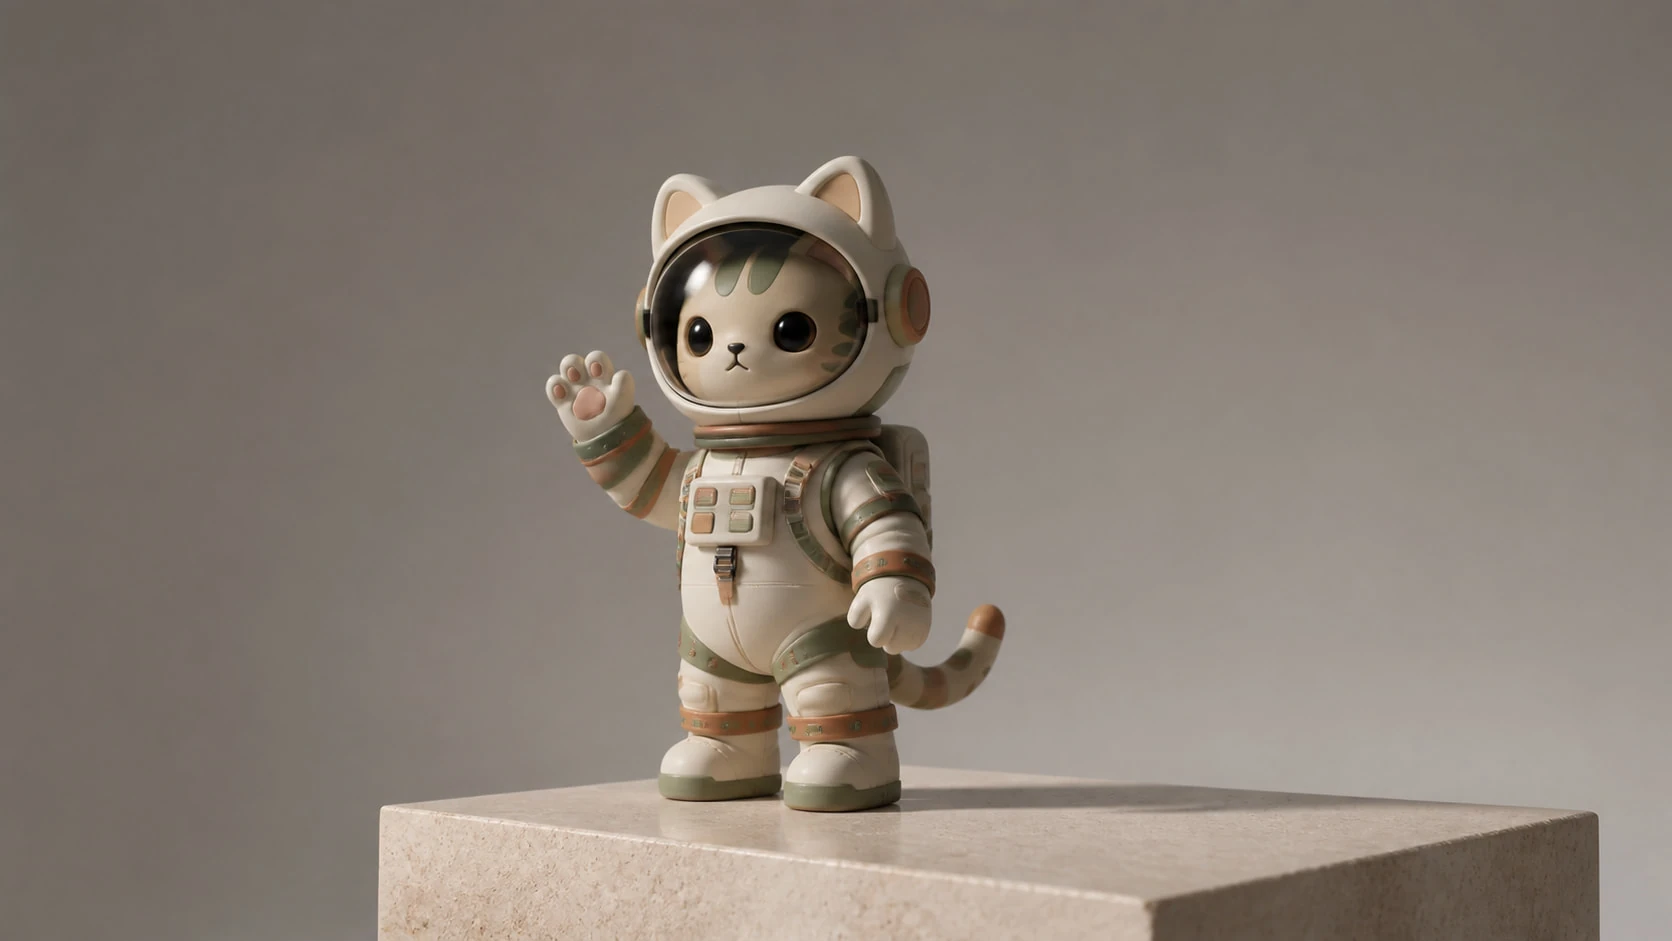
看图重点: 先看约 2.5 头身比例、烟熏玻璃圆眼和极简嘴型,再看低饱和鼠尾草绿/陶土橙配色、哑光 PVC 质感、三分之四挥手站姿、洞石台座与画册式留白。
两轮提问
原帖每个模块都分成「初版指令词 → 继续追问 → 优化后 prompt」三段。这三段其实是两次交给看图模型的提问,最后产出的 prompt 才交给出图模型:
- 第一轮:让看图模型按维度逐项分析,先输出一版中文提示词
- 第二轮:让它在不偏离原图的前提下补全细节,整合成一条完整 prompt
原帖把模块末尾那段叫「优化后 prompt」,但它其实是更好的第一轮提问,不是最后拿去出图的 prompt:它把每一维的候选项直接列出来让模型选(「材质是金属、玻璃还是磨砂」),比只说「分析材质」更不容易答偏。拿来用时,可以直接把这种带选项的问法当第一轮。
通用版可以这样问(把 <图类专项> 换成上表里对应的那一行):
请按主体、风格、配色、光线、构图、质感、氛围七个维度分析这张参考图,
每一维写一两句具体结论;<图类专项>也要单独写出来。
然后把结论整合成一条可以直接出图的中文 prompt:保留核心元素和画面气质,
补上清晰度、画幅和镜头描述,重复的描述只留一处。
复刻和提风格是两件事
这套方法的目标是复刻:尽量保留原图的主体、元素和空间关系。另一种思路是剥掉原图里的具体角色和情节,只提取风格,拿到的是可以套到任何主题上的风格 prompt。
两者的区别就在第 1 维:复刻要把主体写得越具体越好;提风格则要把主体删掉,只留 2–7 维。用之前先想清楚自己要哪种,不然反推出来的 prompt 会带着原图的鹤、木屋、潮玩,套不到别的主题上。
只提风格的效果,看 Gallery · 二次元平面设计风格 —— 12 组二次元风格 prompt,各配两张测试图;原帖作者只提风格、主体留占位符的 15 维反推提示词,在原帖正文存档的「怎样写出自己想要的没有的风格」一节。
更大的图库在 Gallery:7 大类、163 条 GPT Image 2 的中文 prompt,每条都配原图。同一个上游仓库里还有一个反推 skill,收成了本页的完整版从图反推 prompt,可以跟七维拆解对照着看。
还没验证的
- 原帖说整合后的 prompt 可以「直接用于豆包/MJ/SD」,我还没在这三个模型上实测过,也不知道各家对中文长 prompt 的支持差多少。测完再回来补
- 原帖的示例图看起来本身就是 AI 生成的,拿它们来演示「反推后能复刻」是自证式的;换成真实照片效果会怎样,也还没试
维护记录:从哪来、改了什么。正常使用不用看,出问题再看。