---
description: "梨园 Liyuan 拆解:领域是 AI 角色扮演,它把角色扮演从一次生成改成 agent 循环;以网页版 ChatGPT 为 baseline,按设定、状态、长对话、分支、正文、定制、数据七条功能线讲问题和功能,每步配源码模版和实跑效果,结论是能搬走的设计"
---
# 梨园 Liyuan:把角色扮演从一次生成改成 agent 循环
## 摘要 { #abstract }
梨园是一个 AI 角色扮演前端,内核是整份搬进仓库的 coding agent pi[^repo]。拿网页版 ChatGPT 当 baseline——一段 system prompt 写人设、历史全量回放、一次生成定稿——它在角色扮演里会撞上七类毛病:设定塞不下、状态漂移、聊长了上下文爆掉、重来管不住状态、正文改不了、提示词谁都在改同一段、数据带不走。梨园的回答是把一次生成换成 agent 循环:设定由模型自己检索,正文写在带版本的稿纸上、收笔就结束这一轮,记账交给收笔后的旁路调用,所有状态挂在会话树上、按当前分支现算。设计重心是 harness 该替模型管多少:注入顺序、合并规则、权限写死在程序里,查什么、写什么、何时问用户留给模型。
## 关键词 { #keywords }
AI 角色扮演(LLM roleplay,RP)· 角色扮演前端(RP frontend)· role-playing language agents · 角色卡(character card)· 世界书(lorebook / world info)· 预设(preset)· coding agent · agent harness
## 术语 { #terms }
梨园的代码和文档里有一套自己的戏班叫法,各页沿用了一部分。
| 词 | 出处 | 意思 |
|---|---|---|
| 一拍 | 梨园自造,代码里叫 beat | 一轮:用户说一句,模型演一段。各页统一写「轮」,只在引用原话时保留「拍」 |
| 主演 | 梨园 | 写正文的那次模型调用 |
| 场记 | 梨园 | 收笔后专门记账的旁路调用 |
| 世界状态、账本 | 梨园 | 时间、地点、人物、物品、伏笔这份记录;各页叫它场景快照 |
| 稿纸、收笔 | 梨园 | 引擎保管的草稿区;交稿,本轮到此结束 |
| 卡档案 | 梨园 | 卡目录里的 `AGENTS.md`,这张卡的世界规则 |
| 世界线 | 梨园 | 从旧存档接着玩分出来的不同走向 |
| 蓝灯、绿灯 | 酒馆社区 | 常驻的世界书条目、关键词触发的条目 |
| 一轮、场景快照 | 本文 | 替换「一拍」「世界状态」的叫法,见上 |
## 引言 { #intro }
**领域是 AI 角色扮演**——不是通用的 AI 聊天:目标不是回答问题,而是用户扮演故事里的一个角色,和模型一起把故事演下去。
- **软件形态**叫「角色扮演前端」,代表是 [SillyTavern(酒馆)](../sillytavern/index.md):自己不带模型,接用户的 API,管理角色卡、世界书、预设,再把它们拼成 prompt
- **研究界**多叫 role-playing language agents;商业产品那边是 Character.AI 这类「AI 角色 / AI 陪伴」
- **梨园自称 RP agent**:沿用酒馆的卡、世界书、预设格式,把生成那一步换成 coding agent 的架构——工具循环、文件、会话树
主界面,取自梨园 README
**baseline 是网页版 ChatGPT**:一段 system prompt 写人设,历史消息全量回放,每次生成一条回复,生成完就定了。酒馆比它多了角色卡、世界书和预设,但仍是一次生成:每轮把这些材料拼成一个大 prompt,换一条回复。梨园从这里出发,按七条功能线各从一个具体毛病讲起:前一个功能留下的问题,引出下一个功能,只写现状。每条线的细讲是一个子页,每一步贴源码模版和用梨园自己的代码真跑出来的效果。
### 一、设定从哪来 { #setting }
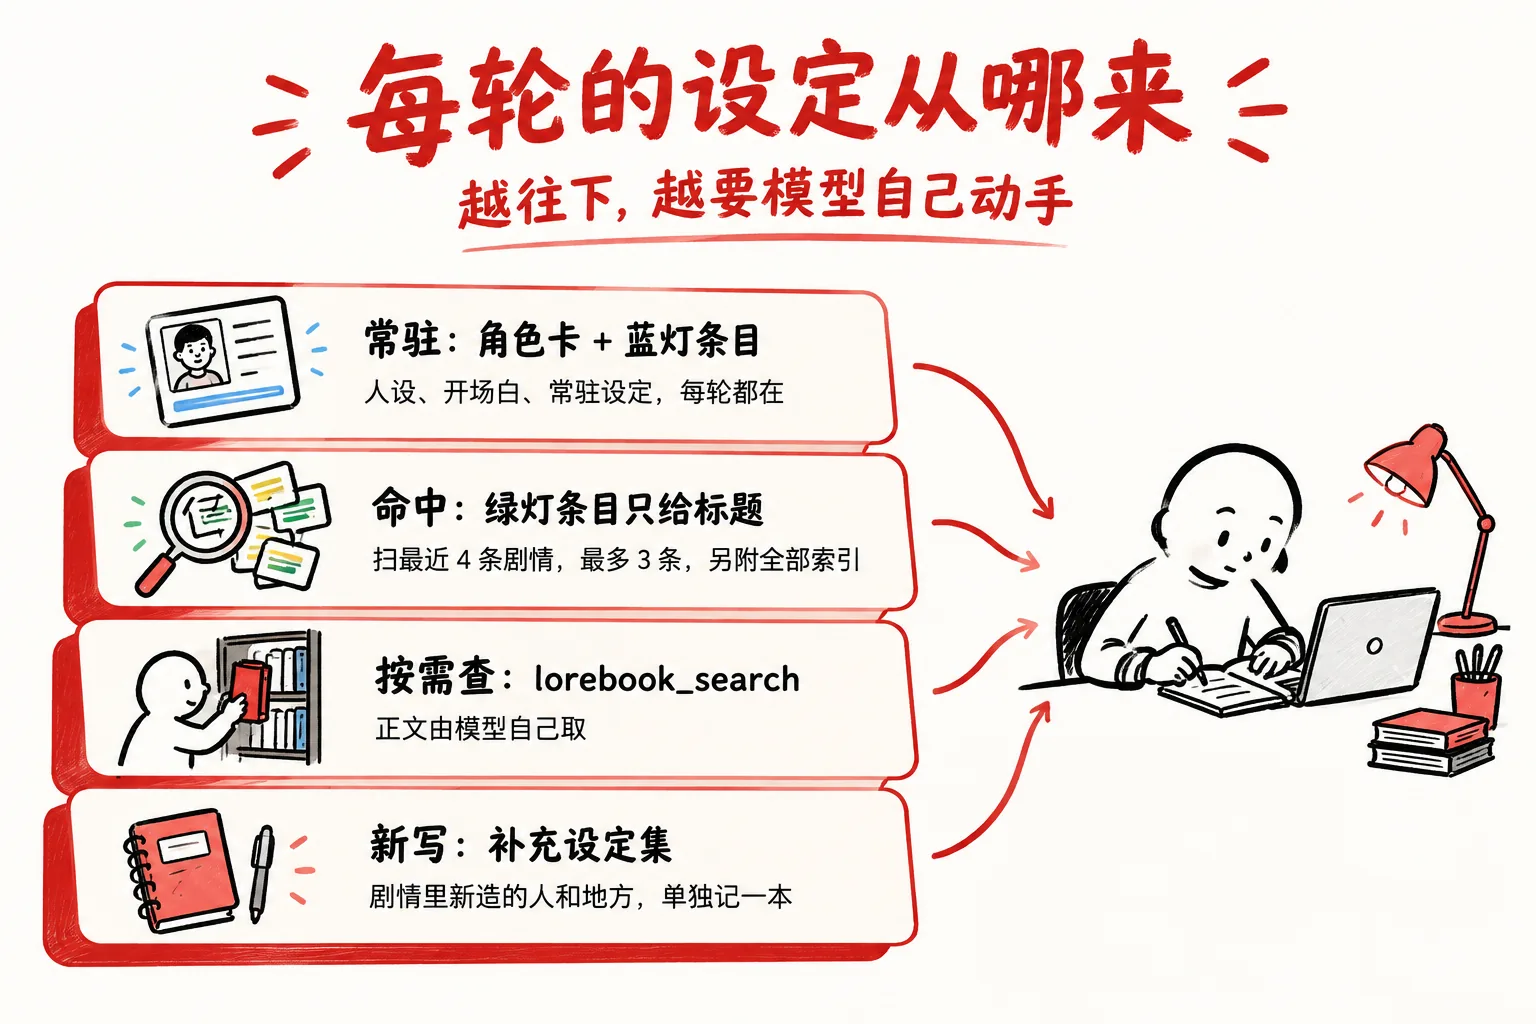
1. 每开一个对话都要重贴人设 → **角色卡**:人设和开场白打包成一个文件,兼容酒馆的卡
2. 一张卡装不下整个世界,几万字的设定全塞进去上下文就满了 → **世界书**:设定拆成条目,常驻条目一直在;其余每轮扫最近 4 条剧情,关键词命中才注入,最多 3 条
3. 命中后直接给正文,模型就把注入的内容当成全部设定,没列出来的名字自己编 → **检索工具**:命中的条目只给标题,另附全部条目的索引,正文要模型自己用 `lorebook_search` 查。实跑第一轮,模型拿到三个标题,先发了 4 次检索才动笔
4. 关思考的模型不主动调工具 → 关思考那一档仍直接给正文
5. 剧情里新造的人和地方,下次就没人记得 → **补充设定集**:模型写进卡目录里单独的一本,不碰原书;可选写入门禁,用户原话里没说「记下」这类话就拦下
细讲:[设定从哪来:越往下,越要模型自己动手](setting.md) —— 角色卡投影进 system、蓝灯和绿灯、命中只给标题让模型自己检索、关思考的档仍给正文、补充设定集和写入门禁
### 二、状态别漂移 { #state }
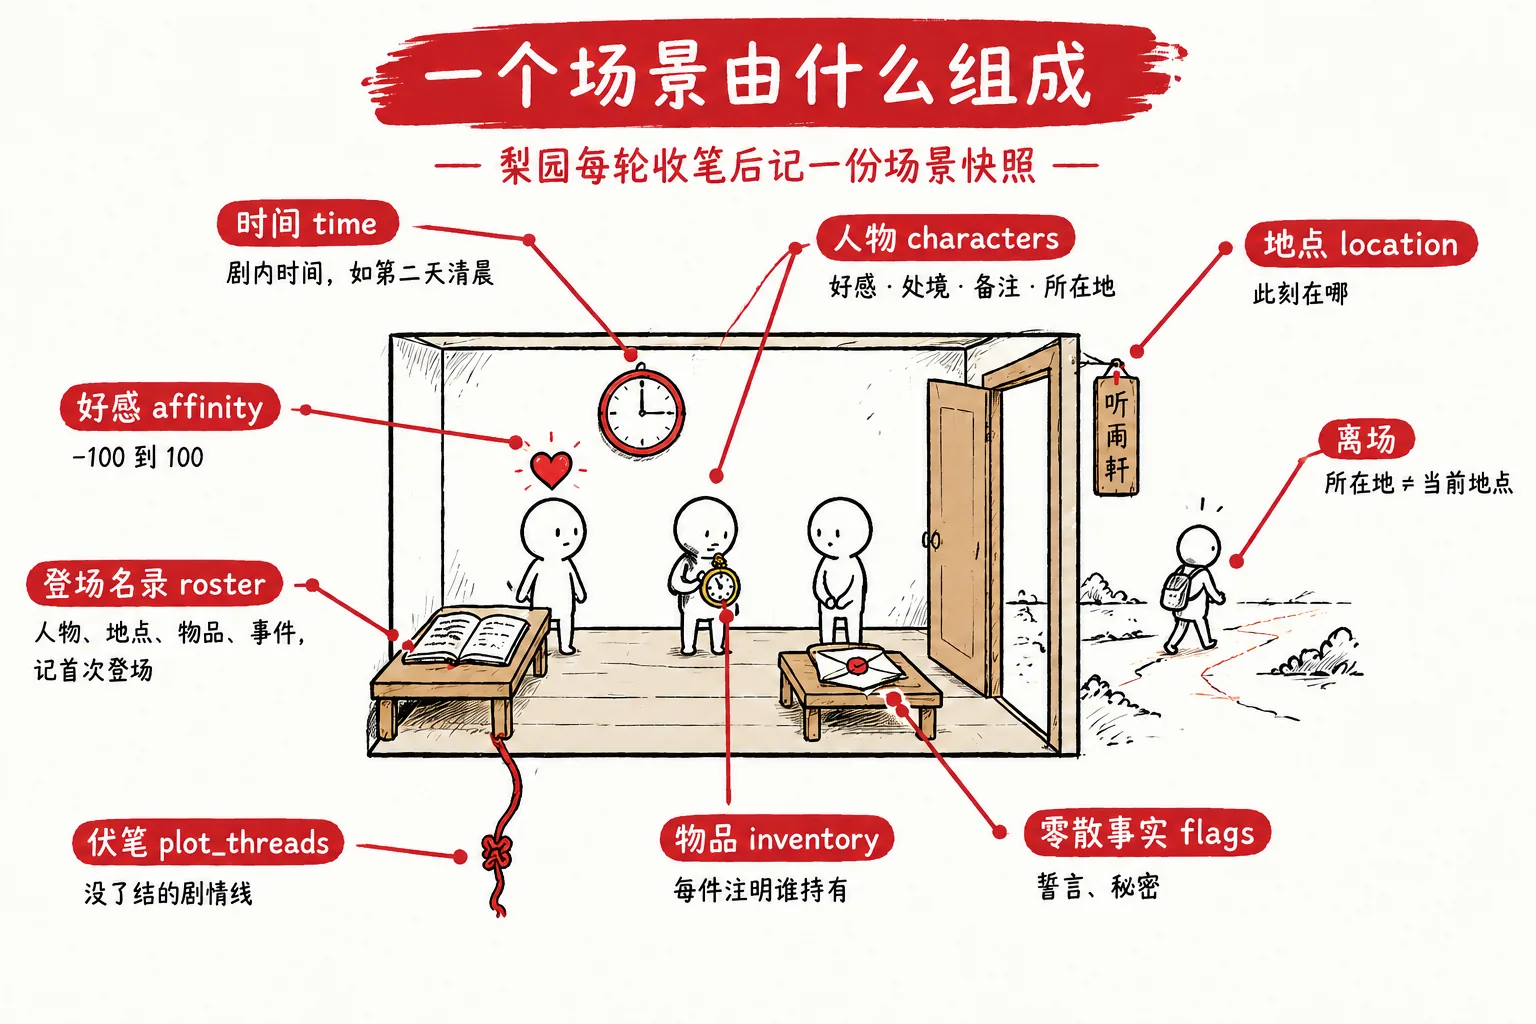
1. 谁拿着什么、现在几点,全靠模型从聊天记录里回忆,否定的事最容易丢:礼物被拒了,下一轮东西已经在对方手里 → **场景快照**:记时间、地点、人物好感和所在地、物品归属、伏笔,每轮放在用户原话前面注入
2. 让主演自己记账,它忙着写戏就漏记 → **场记**:收笔后另起一次调用,只输出 JSON patch;合并规则写死在程序里:好感夹在 ±100,未知字段拒收
3. 快照只有当前值,模型分不清新人和老熟人 → **登场名录**:人物、地点、物品、剧情线只增不删,记首次登场时间
4. 名录里只有人、没有「场」,判断不了谁已经离开 → 每人加一个**所在地**,和当前地点一比就知道在不在场
5. 用户想在界面上看到状态,酒馆的卡还自带状态栏 → **面板**:卡的状态栏和自建面板吃同一份快照,由场记顺手推进
细讲:[状态别漂移:每轮一份场景快照](state.md) —— 快照注入在用户原话前、场记的 prompt 和 patch、程序的合并规则、登场名录、地点和所在地一比判在场、卡的状态栏和自建面板
### 三、聊久了 { #long }
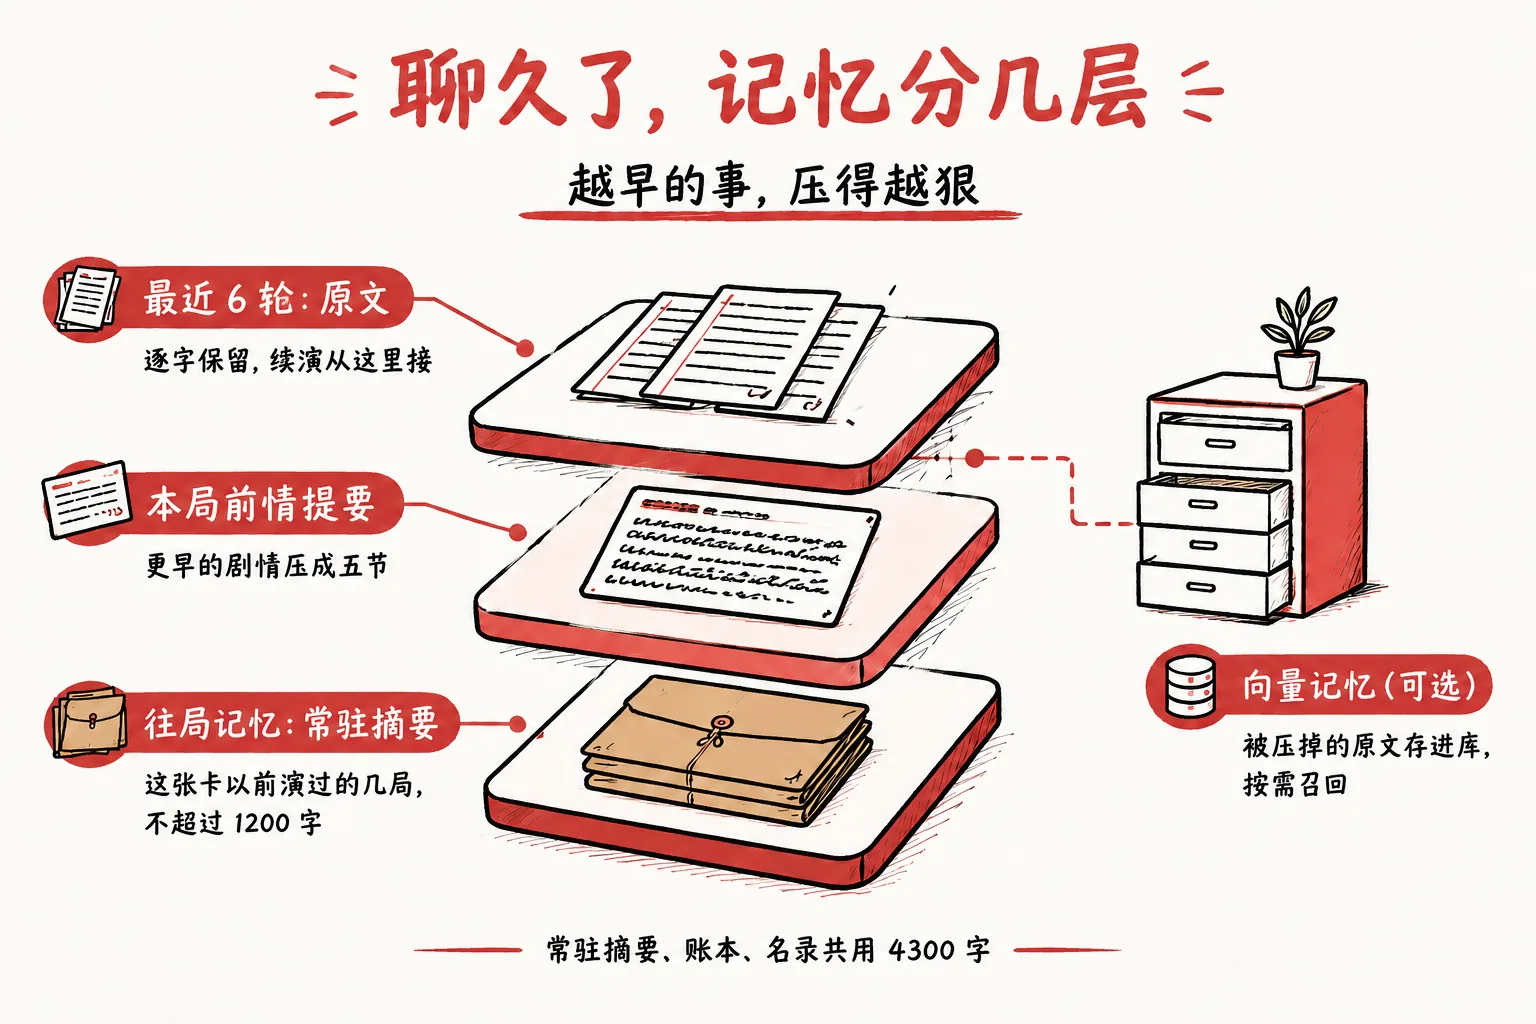
1. 历史全量回放,聊长了上下文就爆 → **剧情压缩**:最近 6 轮留原文,更早的交给旁路模型写成五节摘要,开头以一条【前情提要】回放
2. coding agent 自带的压缩用写代码的模板,压完剧情场景倒回去 → 扮演时取消它,换成剧情专用模板,「当前场景」一节必须写最新的续演点
3. 摘要必然丢细节 → **向量记忆**(可选,默认关):被压掉的原文存进库,按需召回
4. 开新的一局又从零开始 → **跨局记忆**:每局写复盘,合并成一本手册和一份不超过 1200 字的常驻摘要
5. 常驻摘要、快照、名录一起挤每轮的注入 → 三者共用 4300 字预算,长局里往局记忆让位
6. 删掉一局,它的事实还留在记忆里 → **按来源遗忘**:手册条目标上来自哪一局,删掉某局只删仅由它支撑的条目
细讲:[聊久了:越早的事压得越狠](memory.md) —— 五节摘要和回放成【前情提要】、为什么不用 coding agent 自带的压缩、向量记忆、跨局记忆的复盘与合并、共用预算、按来源遗忘
### 四、重来和回档 { #branch }
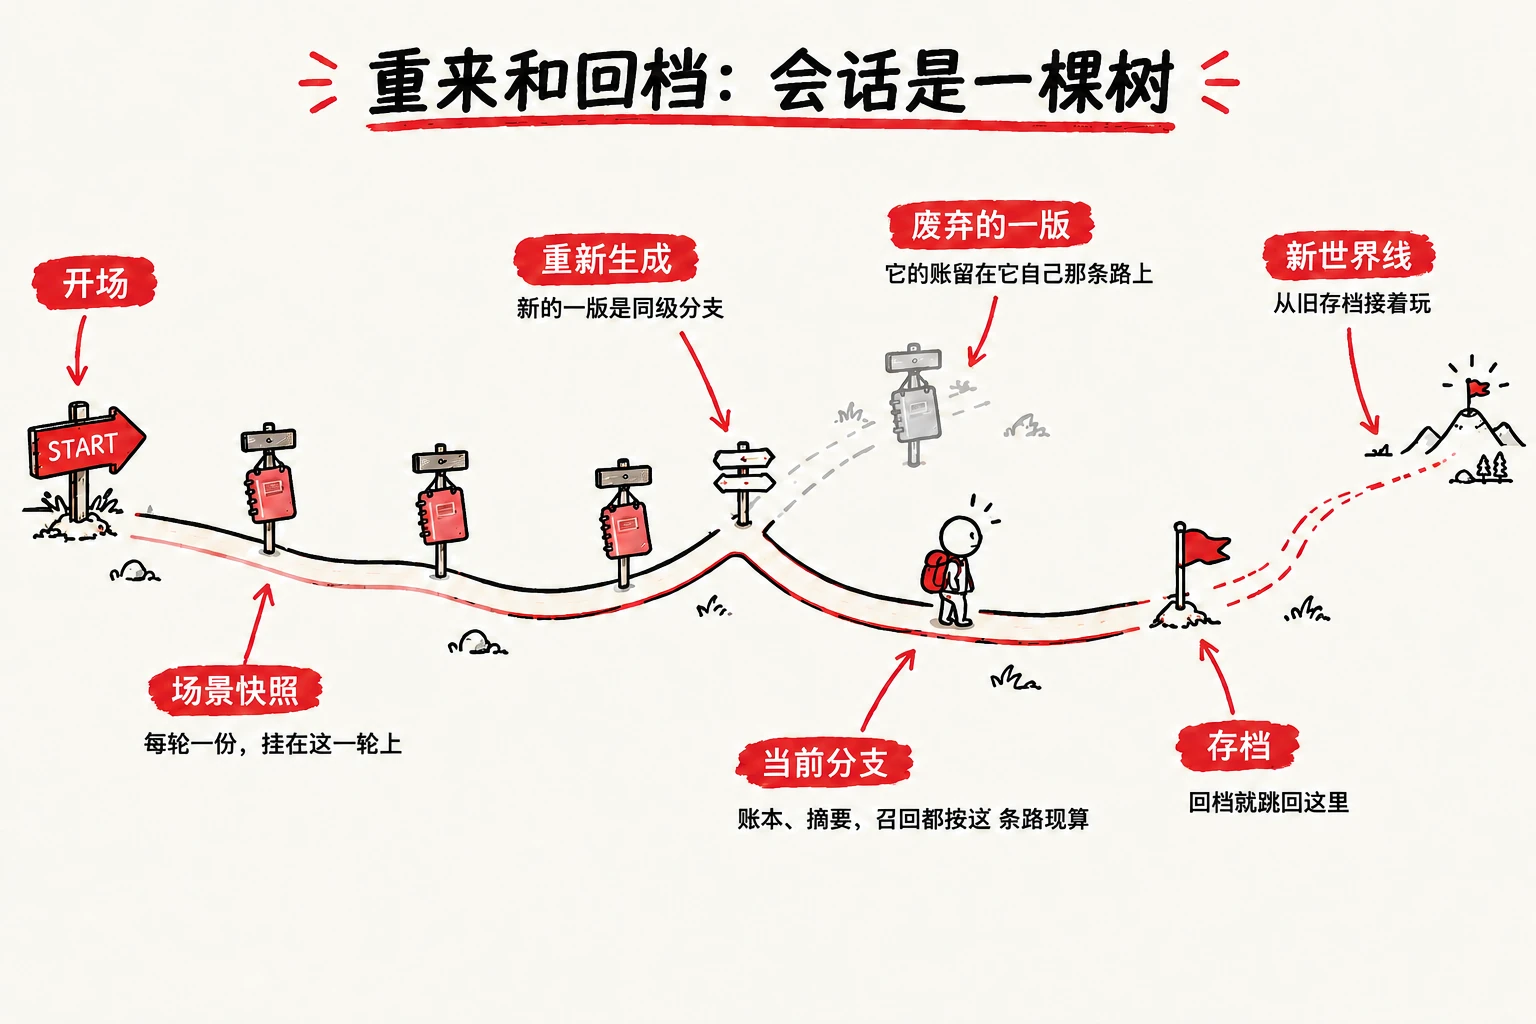
1. 有了账本以后,被废掉的那版已经记过账 → **会话树**:重新生成是同级分支,快照和摘要存成树上的条目、按当前分支现算,废分支的账天然不在新分支上
2. 场记还在跑,用户已经切了分支 → **叶守卫**:旁路调用前后各看一次当前位置,变了就整份丢弃
3. 向量记忆把废稿也召回了,模型把废掉的版本当成上一轮 → 入库带上树节点,召回只取当前分支上的
4. 想停在某一刻,以后换个走向 → **存档和世界线**:存档是树上的点;从旧存档接着玩,自动分出新世界线
细讲:[重来和回档:会话是一棵树](branch.md) —— 重新生成是同级分支、账本按当前分支现算、叶守卫丢掉迟到的账、向量记忆按分支过滤、存档和世界线
### 五、正文怎么产出 { #prose }
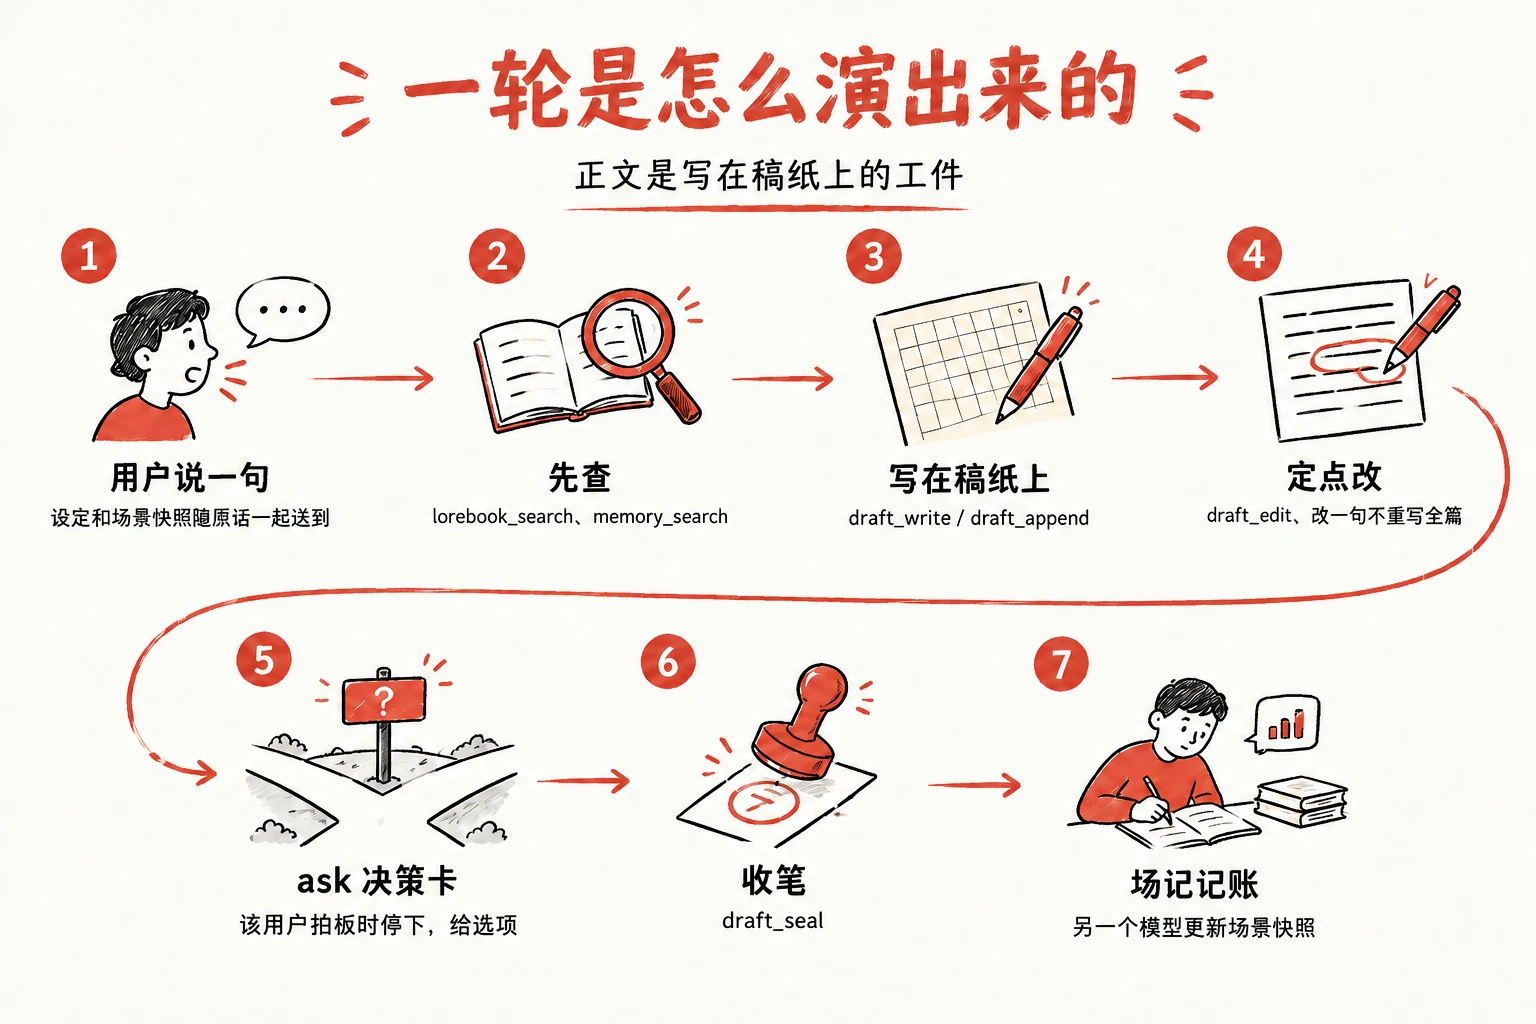
1. 回复一生成就定了,模型为了一次写对在思考里反复打草稿 → **稿纸**:正文写在引擎保管的草稿区,带版本号,能续写、定点改;`draft_seal` 收笔,这一轮就此结束
2. 用户说「上一轮那句改成……」 → `previous_draft_edit` 原位改上一轮
3. 有的模型不调工具直接输出,有的在稿纸外另出状态栏 → 直出的正文代收进稿纸;稿纸之外只认格式块,重述的正文丢掉
4. 模型替用户选剧情走向 → **ask 决策卡**:到了岔口停下,给几个选项
5. 想写成长篇,要回头改第三章 → **agent 模式**:一章一个文件,模型用文件工具改任意章节,正文不进上下文、只给目录
6. 改坏了想回去 → 每轮末存一个按内容哈希的**检查点**
细讲:[正文怎么产出:写在稿纸上的工件](prose.md) —— 一轮里发出去的消息、稿纸工具、收笔即结束、改上一轮、稿纸之外的输出、ask 决策卡、agent 模式的章文件和检查点
### 六、谁来定制,能改到哪 { #custom }
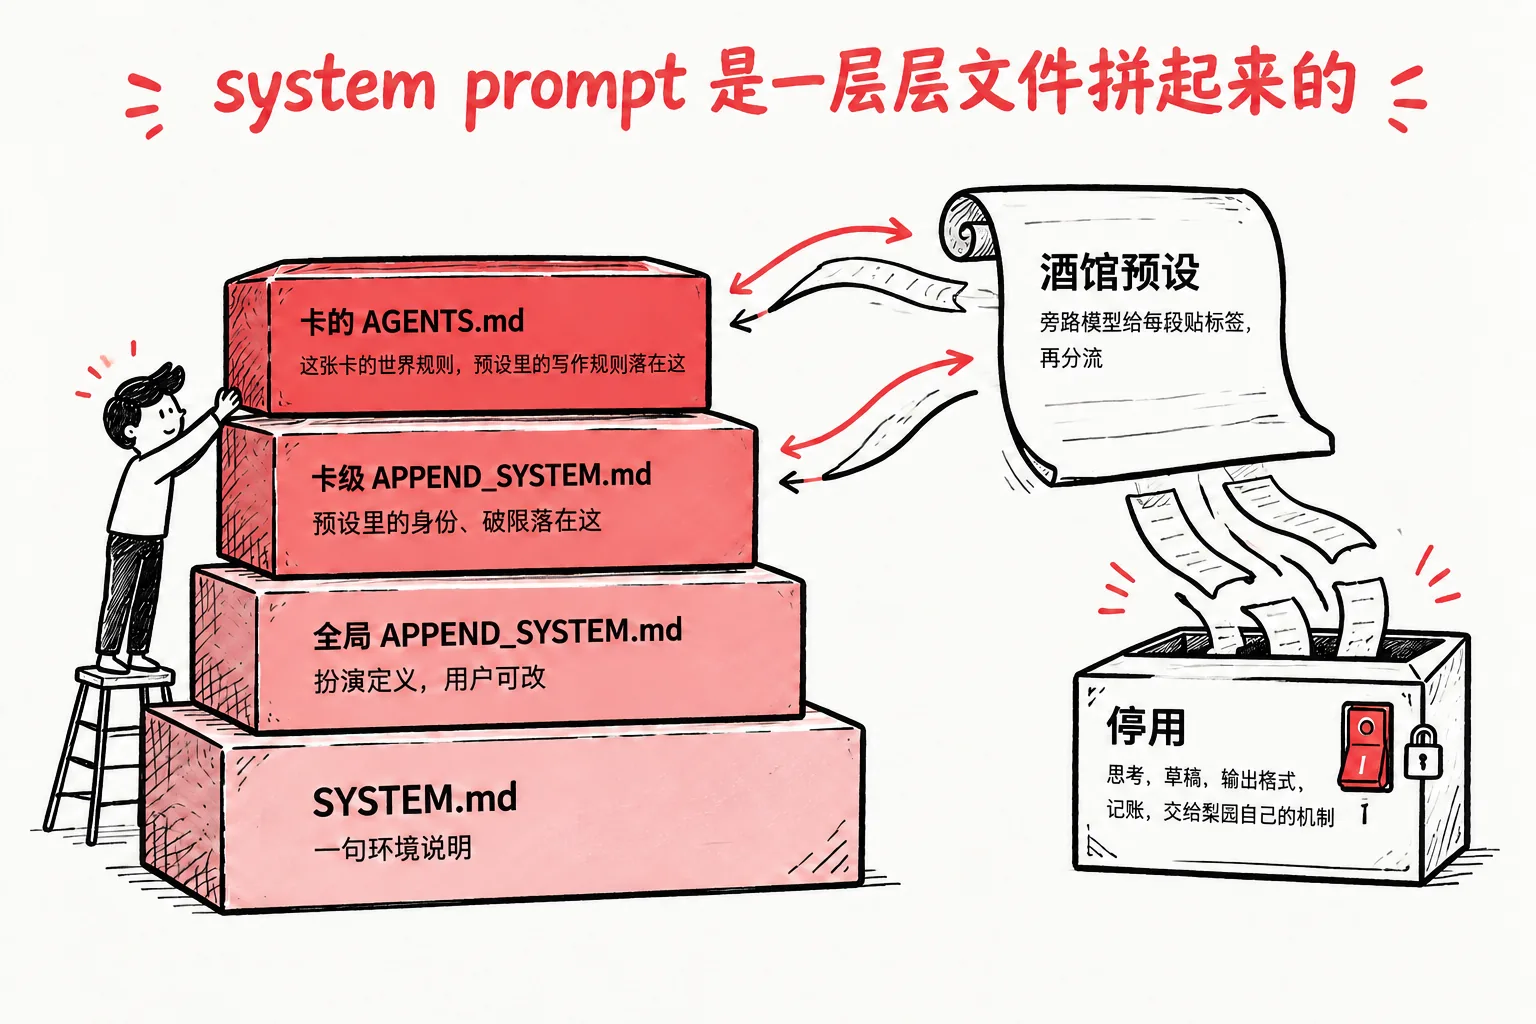
1. 引擎规则、角色设定、用户的规矩混在一段 prompt 里 → **提示词分层**:环境说明、扮演定义、卡的身份、卡的世界规则各一个文件;文件是正本,界面上是可开关的条目
2. 酒馆预设是为一次生成写的,原样拼进来会和 agent 机制打架:实测思考量涨到 11 倍,模型还把它判成恶意注入 → **预设声明**:旁路模型给每段贴标签,身份和写作规则留下,思考、草稿、输出格式、记账写成关掉的条目
3. 用户想让 AI 帮忙改卡 → **工作模式**:模型自己切进去,卡展开成工程按槽位改,这段对话不进剧情
4. 模型拿到文件工具后可能改到卡以外 → **沙箱**:每次调用工具前判一次,卡目录随便改,越界弹卡等用户批
5. bash 绕过了这道门,一个清理脚本删掉 60 多本世界书 → **命令黑名单、免问前缀、素材快照**
细讲:[谁来定制,能改到哪](custom.md) —— 实跑 system 逐段对照各层、条目开关、酒馆预设的标签分流、工作模式改卡、沙箱十次判定
### 七、数据带得走 { #storage }
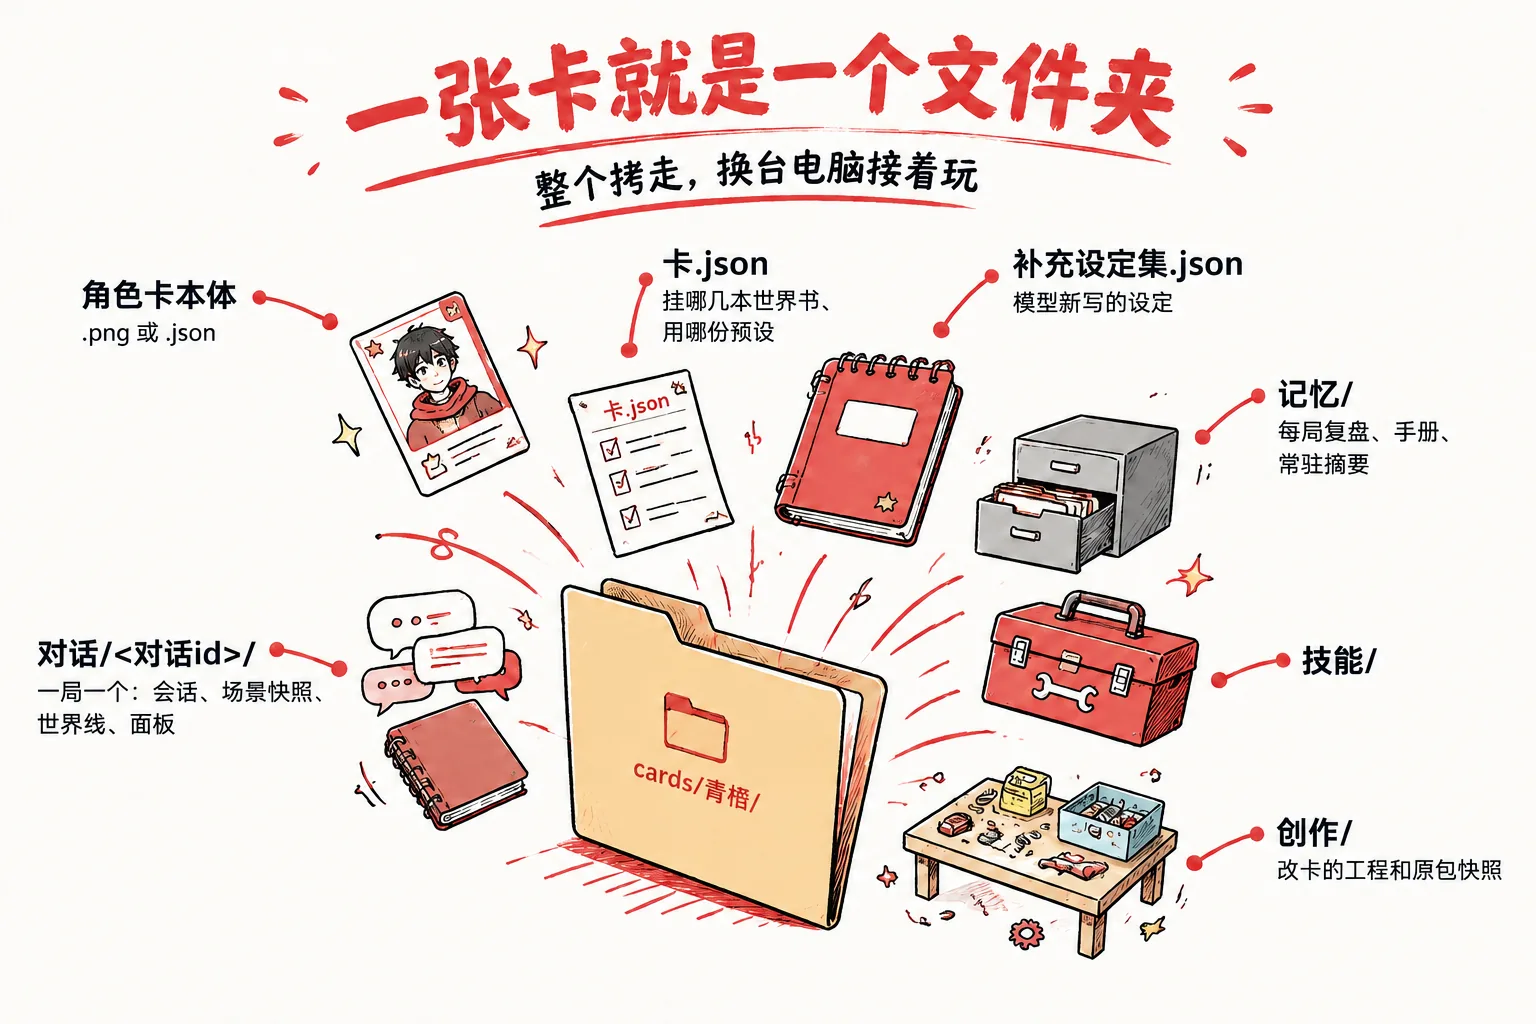
1. 一张卡的会话、账本、记忆散在全局目录里,换电脑带不走 → **卡就是工作空间**:全部收进 `cards/<卡>/`,整个目录拷走就能接着玩。只有这一项,不另开页
## 局限 { #limits }
只列设计上的取舍:
- **没有系统级隔离**:沙箱是工具调用前的路径判定,设计文档自己认下「批了 bash 就是批了整台机器的 shell」,命令黑名单「防手滑,不防蓄意绕过」,兜底靠素材快照
- **场记只看本轮**:场记的输入是账本加本轮对话,没有角色卡。正文没写到的设定会被记成别的说法——实跑里卡上的「听雨轩」被记成了「青梧的客栈」,而在场判定只比字符串
- **每轮的固定开销大**:33 个工具说明 13221 字,一轮还没开演提示词已约 7000 token,靠前缀缓存撑着
- **agent 模式改中间章,后面不跟着变**:身份说明里写明「改中间章之后,账本、摘要与后文不会自动跟随」
## 结论:可以搬走的设计 { #takeaways }
- **数据块放在用户原话前面**:每轮注入的状态、设定压在用户这句话之前,用户的话贴着生成点。反过来放,模型会把提问读成历史里的旧话,既不检索也不正面回应。任何每轮拼上下文的 agent 都适用
- **注入线索,不注入答案**:检索命中只给标题和全库索引,正文让模型自己查——模型才不会把注入的内容当成全集。对不会调工具的模型退回直接给正文
- **写和记账分开**:主演只读状态;收笔后让便宜的模型出一份 JSON patch,程序按死规则合并,告警原文回给记账的模型。需要维护结构化状态的对话 agent 都能照搬
- **状态挂在会话树上,按当前分支现算**:不存可变的全局状态文件,存成树上的条目。重来、回档、切分支都不用写恢复代码;旁路调用前后比一次当前位置,变了就丢弃结果
- **产出是带版本的工件,交付即终止**:正文放在工具管理的草稿区,版本号防冲突、能定点改;交付工具一成功就结束 agent 循环,交稿后的话没有机会说出口
- **外来提示词先分类再分流**:用户自带的大段 prompt 不原样拼接,让旁路模型给每段贴一个固定类别,按类别落到不同文件或关掉;拿不准就保守保留,用户能一键打开
- **记忆按来源遗忘**:长期记忆的每条都标上来自哪份材料,删材料时只删仅由它支撑的条目
[^repo]: [weidu12123/Liyuan](https://github.com/weidu12123/Liyuan),2026-10-19 读。
---
维护记录:[读的哪个版本、素材从哪来、实验怎么跑的](../../maintenance/projects/liyuan.md)。正常阅读不用看。