彩色手绘三维穿梭视频
把照片画成彩色手绘,再按颜色和笔触拆成六层透明画面,放进同一个三维空间:正对着看是一张完整的画,镜头一侧移就散成一层层笔触,穿过去、拐个弯,再从新角度拼成下一个主体。三维感来自透明画层和镜头透视,不是从照片里恢复出三维模型。如果要调用 2 次以上本 skill 中的脚本,直接将本 skill下载到本地。做一支视频就要依次跑拆层、构建、渲染三个脚本。
流程
| 步 | 做什么 | 用什么 |
|---|---|---|
| 1 | 每个主体画一张方形彩色手绘底稿 | 底稿的 prompt,调生成、编辑图片的编辑接口 |
| 2 | 配乐 | 配乐 |
| 3 | 拆层、构建离线 HTML、逐帧渲染成 MP4 | 渲染工程里的三个脚本 |
| 4 | 查画面和声音 | 验收 |
① 底稿
- 1–8 个清楚的主体,先记下来源。真人、宠物用用户给的素材或核对过来源的图;用户允许举例时可以生成示例,交付时注明哪些是生成的。群像和名画只取画里真有的主体
- 每个主体一张独立的方形彩色手绘,至少 512 像素,细毛和近景要 768 以上。照片必须先画成手绘——程序提边代替不了这一步
- 多个主体在姿态、大小、表情上拉开:动物可以拿耳尖、胡须、爪子、毛色和视线做构图,别全画成正面证件照
- 底稿要照着分层脚本的假设画:
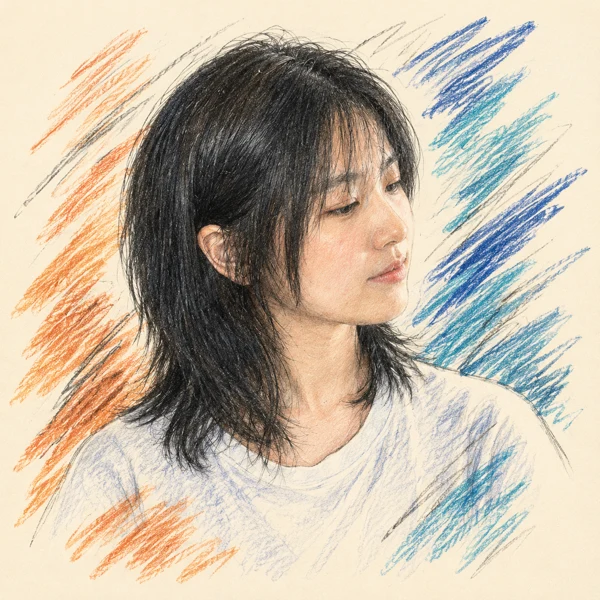
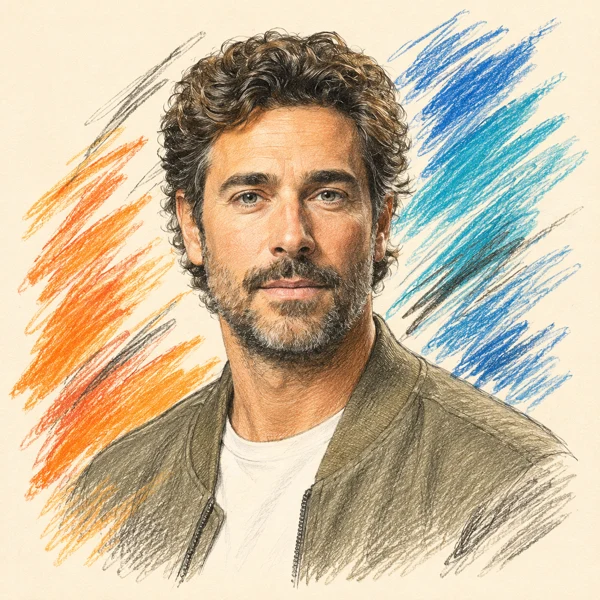
layers_v2.py拿纸色当透明底,纸色写死在(251, 243, 228);冷色层按蓝、青挑,暖色层按橙挑;人物的脸要落在画面水平正中、偏上的一个椭圆里。下面这段 prompt 就是照这几条写的,原图传主体的照片,size写"1:1"
把照片里的画成一张方形的彩色手绘肖像,只画头和肩膀:脸在画面水平正中、略偏上,头顶离上边留一点空,头和脸占画面宽度的六成左右,肩膀落在画面下三分之一。保留能认出的五官、发型、脸型和表情,不美化、不换脸。
画法:暖米白色的纸底,接近 #FBF3E4,整张纸平整干净,身后没有任何照片背景。用石墨细线勾出五官和轮廓,头发和衣服用疏密不一的排线;脸上薄薄一层暖色彩铅,衣服按原照片的颜色淡淡上色。两侧和身后是大幅、松散、快速的手势笔触:一组橙色笔触(#D85B28 一带)从左下往右上扫,一组靛蓝和青色笔触(#2A4A8F、#3D91A4 一带)从右上往左下扫,中间夹几笔深灰石墨长线;笔触散到画面边缘,但不盖住眼睛和嘴。
不要:照片质感、纯白或深色的背景、大块渐变色、边框、文字、签名、水印。
- 只实测过人物。动物、物件把「头和肩膀」「五官」换成对应的部位,构图照样让主体落在中间偏上
- 一张一次改图,两张并发各要两分半左右,出来是 1254×1254,分层时缩到
--size - 纸色出来在
(250, 236, 211)一带,比脚本写死的偏黄。分层后纸面在构图层里留了约 5% 的不透明度,颜色跟底色几乎一样,成片里看不出方块。脚本按跟(251, 243, 228)的色差算透明度,纸色差得越远,纸面留得越实,验收时单独看构图层(construction)
② 配乐
- 默认现做一段:调生成音乐的 clip 版,一段 30 秒左右的 MP3、0.04 美元,十几秒返回。prompt 写明纯音乐、不要人声,再写乐器、情绪、速度,加一句「每两小节一个清楚的重音」,好把主体的到达落在重音上
- 总长 = 最后一个主体的到达点 + 每主体时长 + 片尾 1.34 秒,两个主体默认是 8.34 秒。用 ffmpeg 截出这么长,末尾留自然收束或淡出,存成
assets/music.mp3 - 曲子比视频短:再生成一段,检查过接缝再交叉淡化接上,或者换 pro 版出整首;不要默认它能无缝循环
- 用户认可的现有音乐优先,一直用到片尾;被否掉的就换。别从参考片里扒音乐
- 用户要现成的曲库:作者默认用 music.shapeof.world1。先读它的
llms.txt,照里面的索引按时长、情绪、乐器挑,读每首的元数据核对rights:商用只选commercialUse为真的,要免署名还得attributionRequired为假,没写的不算有授权;从返回的确切地址下载,不按曲名猜地址,许可和来源存下来 - 查音轨:完整、时长对、能解码、峰值正常。能听就真听,听不了就明说没听过,别把元数据和自动检测写成听过
③ 拆层、构建、渲染
渲染工程是下面 9 个文件,整包解压出来就是这个目录;逐个取的话,按这个目录结构放进项目里的一个新目录。下面都叫 starter 目录:
| 文件 | 干什么 |
|---|---|
requirements.txt | Python 依赖:Pillow、numpy、playwright |
tools/layers_v2.py | 把底稿按颜色和边缘拆成六层透明 PNG,写 manifest.json |
tools/build_v2.py | 把各层、配乐、场景 JSON 塞进一个离线 HTML |
tools/render.py | 用 headless Chromium 逐帧取画面,ffmpeg 合成 MP4 |
tools/verify_v2.py | 验收 HTML |
tools/inspect_motion.py | 按时间点出真实渲染的联系图 |
src/v2.html | HTML 模板 |
src/v2.js | WebGL2 渲染器和默认运镜 |
src/motion_variants.js | 四种空间转场 |
装上 requirements.txt、Playwright 的 Chromium 和 ffmpeg。底稿放进 assets/art/,配乐剪好存成 assets/music.mp3,在 starter 目录里跑:
python tools/layers_v2.py --art assets/art/a.png assets/art/b.png --names '主体一' '主体二' --subject-kind person --size 768 --out-dir assets/layers
python tools/build_v2.py --mode generic --manifest assets/layers/manifest.json --audio assets/music.mp3 --out output/parallax-ink.html
python tools/render.py --html output/parallax-ink.html --audio assets/music.mp3 --output output/parallax-ink-720p.mp4 --width 720 --height 1280 --fps 30 --jobs 2
--subject-kind person|animal|object按实际主体选,默认person,一次只能选一种。animal让成片的毛留在一起,不按一根根毛拆层,否则缩小时会出透明碎点;object用更宽的内容区。它们都是按颜色和边缘拆,不是准确的解剖分割;白毛、复杂背景、低对比的素材要单独查透明层--art必须给,--out-dir必须在 starter 目录里面:不给--art会去读作者工程里的一张联系图,starter 里没有这张图- 时长:默认每个主体约 3.5 秒,片尾 1.34 秒;
--block-seconds、--duration改时长,--arrivals 0 …填按实际音频听出来的每个主体到达的时间点。别用旧版每人 6.4 秒的慢轮播 - 一张图只做这个主体的拆层、穿越和回看;多张图可以用折返空间、翻页、纵深通道或正交房间。对齐视点下各层拼成完整的画,侧着看就分开。主体和它的笔层前后保持同一身份;淡出可以配合真实的空间位移
--scene scene.json可以排主体的大小和位置、镜头关注哪里、滚转、细线和片尾,字段见场景 JSON。这些是可选的美术方向,人物默认不加猫爪、毛线这类东西- 用户要多种转场,用四种空间转场,每种单独交一支真视频,可以再做一个同步四宫格方便比较。实验方案和已经认可的默认运镜分开保存
- 先渲一小段确认真在动,再导 1080×1920。HTML 内嵌了贴图和音乐,离线能打开、能播放和拖动;
__renderAt(t)按时间确定地取帧,镜头快速掠过时加短快门模糊。原图、分层、场景参数和最终 MP4 都留着
实测时撞到的:
- 不写场景 JSON,片尾印的是作者的字:「线 的 另 一 面」和「PARALLAX INK / MAKERJACKIE」,
render.py也把 MP4 的 artist 元数据写成 MakerJackie。片尾的字在场景 JSON 的outroTitle、outroSubtitle里换 - 人物默认路线没有对齐停留:第一张脸 0.7 秒就开始散,来不及看清。在场景 JSON 写
"alignedHoldSeconds": 1.2,每个主体先停稳再拆 - 快:两个主体、8.34 秒、720×1280,渲染 21–25 秒。HTML 24 MB;MP4 用 crf 17 压,8 秒就有 15–21 MB,放网页要再压
- Chromium:
render.py先找 PATH 上的chromium、google-chrome,都没有就用 Playwright 自己下的那份
场景 JSON
build_v2.py --scene scene.json 把 JSON 当数据嵌进 HTML,不用改渲染器。五只猫那次的场景是 parallax-ink-cats-scene.json,不带图和音乐。
| 字段 | 用法 |
|---|---|
motionVariant | 可选 fold / dive / cube / bloom,自带一套空间、镜头和画层运动,不能和 families、accents、ending 一起用,见四种空间转场 |
families | 跟主体一样多的数组;每项 center 是 [x, y, z],yaw 是弧度,size 是相对画面大小 |
accents | 跟主体一样多的数组;focus 是 [局部水平, 局部竖直],把镜头关注点挪过去;lift 是运镜抬升量,bank 是额外滚转的弧度。写空对象就用默认 |
alignedHoldSeconds | 每个主体到达后,所有层完全对齐停多少秒;猫版是 1.2,省略或写 0 保留原来的人物运镜。不能超过最短主体间隔的 45%。停留两端速度归零,免得插值漂移;只压缩后面的穿层时间,音乐到达点和总长不变 |
bridgeOpacity | 0–1,连接笔触的固定透明度,细毛素材可以调低,免得盖住主体。不随时间变 |
thread | true 时加一根固定在三维空间里的细毛线,猫这类需要一条连贯线索的画面可以用;默认关 |
ending | 可选,三个片尾镜头姿态,依次用在最后一段后部、收束起点、最后一帧;每项 eye、target 是三维坐标,roll 是弧度。不写时间 |
outroTitle / outroSubtitle | 片尾短标题,不挡主体 |
focus的原点是画面中心,向右、向上为正,画面通常宽约 3.46×size个世界单位。橘猫的爪子在右下,可以取[0.7, -0.65];耳朵在上方,可以取[0, 0.8]。数值跟着构图变,不会自动识别- 固定对齐视距是 6.2。改了布局,先跑
python tools/inspect_motion.py --html output/parallax-ink.html --out qa/inspect --times 0 1.8 2.5 3.5 …,看每个主体成立的视点、近景掠过、新旧主体同时可见的拐角和结尾。它出的是真实渲染的联系图,代替不了动态播放
四种空间转场
在单独的场景 JSON 里写 motionVariant。几种方案用同一组分层底稿和连续的镜头,每个主体都留 alignedHoldSeconds 的阅读时间,默认 1.2 秒。五只猫的参数别直接套到别的素材上。
| 值 | 空间和效果 |
|---|---|
fold | 画面绕相邻的边翻开,各层略微错开,像透明的折页。镜头横移、略微升高 |
dive | 主体沿纵深排开,镜头往前钻进笔层,带一点绕轴旋转;下一个主体从深处放大出来 |
cube | 主体在互相垂直的墙面、顶部、底部,镜头转向时拉开,能同时看见几个朝向。最多 5 个主体 |
bloom | 冷暖笔层各自位移、旋转、淡出;下一组笔层从散开的状态聚拢,配合镜头放大 |
{
  "motionVariant": "fold",
  "alignedHoldSeconds": 1.2,
  "outroTitle": "猫 的 另 一 面",
  "outroSubtitle": "HINGED INK"
}
- 照常用
build_v2.py --mode generic --scene scene.json和导出命令。转场模式自己定布局、镜头和片尾,所以这份 JSON 里不写原路线的families、accents、ending;原路线不写motionVariant,毛线只属于原路线 cube的画面位置固定;其他三种会移动、旋转画面,也会改透明度。每一层贴图始终是同一张。用户要翻转、淡化,不能拿「物体必须完全固定」去拒绝- 先逐帧查每次过渡,尤其是正交房间的留白、镜头背后的曲面穿进画面、放大时稀疏的笔层盖住下一个主体。完整对齐那段必须稳,快速段不要求每帧都拼成完整的头像
- 几种方案都是等用户挑的实验,不自动继承默认人物路线已经得到的认可
④ 运镜与声音
- 完整的主体要留出看清的时间。猫版写了
alignedHoldSeconds: 1.2:对齐期间镜头停在校准视点,再侧移拆开 → 近景掠过 → 看见拐角 → 下一个主体对齐;快速穿层和对齐停留分开调。拐角必须同时看见上一个主体的侧面笔层和下一个主体,别用一次遮挡把整张图换掉 - 变化来自真实的构图:小主体从大主体边上露出来,沿耳尖往上转,贴着爪子掠过,最后回到完整的表情。底稿里的抬爪、打哈欠是画出来的姿态,别说成动物肢体的逐帧动画
- 按实际音频的节奏排到达、掠过、收束。曲子标的 BPM 只是估计;记下剪辑起点和卡点依据。峰值检测和自动审核不能冒充人工试听。结尾留自然收束或做淡出,不能提前没声、生硬截断
- 配音只在用户要时加:先拿同一句短文、不配乐、不变速的音频让用户试听,选定音色再生成全文,按实际配音调字幕,说话时压低配乐。声音用生成语音
⑤ 验收
- 它查基础网格、确定性、完整停留,以及离线播放、跳转、拖动。固定空间的模式查世界坐标不变;翻页、散层的模式查实际变换跟配置一致,别把它们报成固定的世界几何
- 在浏览器里用
__setLayerVisibility('cool-shadow')这类调用单独看每一层,确认没有纸白色的矩形,完整展示时特征没丢 - 再查实际的 MP4:ffprobe 信息、全片能解码、开头和每次转向和结尾的连续帧、音轨完整。能听就真听一遍,听不了就明说
- 交可播放的 MP4、源码和 HTML、几句验证结果。分清工程通过、看过画面、听过声音、用户认可这四件事,不承诺任何输入都能自动做到一样的效果
能做到哪一步
- 作者做过的:五张 AI 生成的人像出过 36 秒 1080×1920 的成片,五只猫出过 18.84 秒的版本,人物加猫配音合成了 41 秒(就是页首那支);单张猫、两张混合输入通过了 HTML 启动和关键帧检查
- 没证明的:任意低质照片、复杂群像、所有名画都能自动拿到一样的画面;底稿要人看过,分层有时要按图调
- 多个人同框是固定的透明画面加真实镜头透视,不是从照片里还原出三维人体
实测
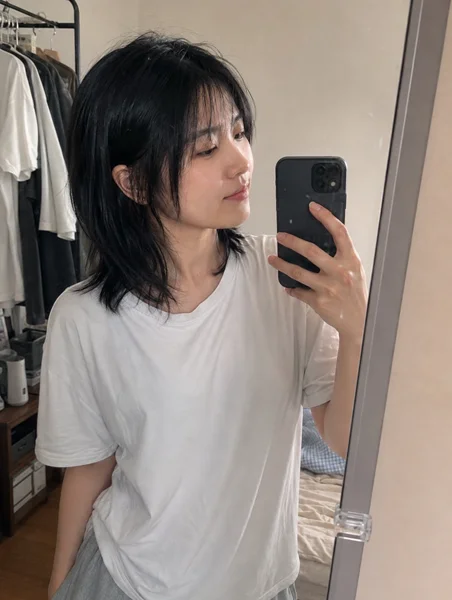
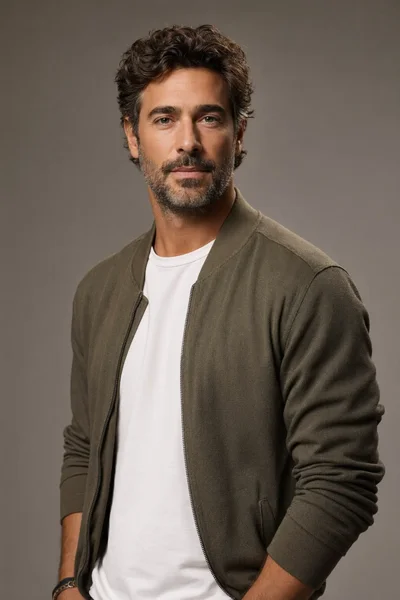
2026-10-17 拿 Gallery 里两张 AI 生成的人像(摄影的对镜自拍、时尚大片的影棚肖像)走了一遍,页首右边那支就是:
- 底稿:照底稿的 prompt 各改一次图,155 秒、162 秒
- 配乐:Lyria clip 出一段 30.8 秒,截前 8.34 秒,末尾 0.84 秒淡出。主体到达用的是默认每人 3.5 秒,没按重音排;配乐没人试听过
- 分层、构建、渲染:分层 3 秒,渲染 250 帧 21 秒;
verify_v2.py全过,没有外部请求和页面报错 - 两版:第一版没写场景 JSON,第一张脸刚出来就散,片尾是作者署名;第二版加了 1.2 秒对齐停留和自己的片尾字,两张脸都停稳了,收的是这一版
- 花费:改图两次(单价没查),配乐 0.04 美元
第二版的场景 JSON 和配乐 prompt
-
music.shapeof.world,「世界的形状」曲库,2026-10-17 确认能访问,没实际选曲下载。 ↩